主题
2-1DOM及相关案例(二)
本页对应 第二章WebAPIs,共 5 段视频,约 41 分钟。
学习目标
- 能够使用
getElementById、getElementsByClassName、getElementsByTagName、getElementsByName获取指定 DOM 元素,并正确判断返回结果是单个元素还是类数组。 - 能够通过 DOM 对象读取、修改、新增和清空元素内容,分别使用
innerText和innerHTML完成文本写入、内容替换与空字符串删除。 - 能够对比说明
innerText与innerHTML的差异,并在需要解析 HTML 标签时选择innerHTML,在仅写入纯文本时选择innerText。 - 能够使用字符串拼接和
innerHTML将循环生成的列表项一次性渲染到指定父元素中,完成学成在线案例的重构。 - 能够使用随机数从数组中抽取姓名并写入指定
span,使用splice删除已中奖姓名,完成一等奖抽取且不重复。 - 能够复用一等奖逻辑完成二、三等奖抽取,检查随机索引、目标元素和删除位置,确保三个奖项姓名不重复。
知识点
DOM 是什么:先理解它解决的问题
DOM 的英文是 Document Object Model,中文叫“文档对象模型”。本节笔记给它的定位很明确:DOM 用来操作网页文档,开发网页特效和实现用户交互。
为什么需要 DOM?因为网页写好后,如果只用 HTML 和 CSS,页面内容是静态的:文字、盒子、图片都在那里,但 JavaScript 很难直接“读到”或“改掉”它们。DOM 提供了一层可被程序操作的对象模型,让 JavaScript 能访问网页内容,并修改页面。
怎么想?不要把 DOM 想成另一门语法,而要想成“浏览器把网页内容整理成对象,JavaScript 通过对象去操作页面”。所以核心不是背 API,而是记住一条链路:先拿到对象,再改对象属性或调用方法,页面会跟着变化。
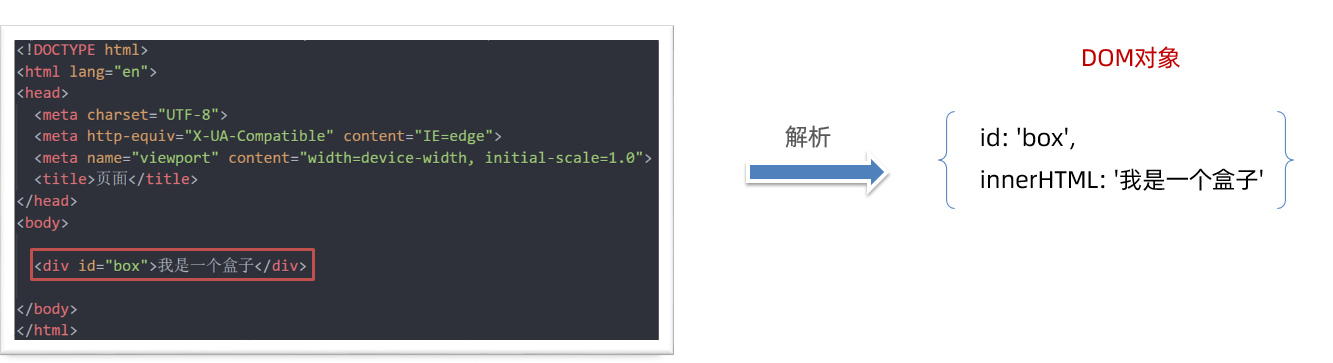
易错点:DOM 不是 CSS,也不是 HTML 标签本身;它是浏览器提供给程序操作网页内容的接口。后面所有“获取元素、改内容、改样式”的操作,都建立在这个对象思想上。
核心思想:把网页内容当成对象处理
本节笔记强调:DOM 的核心思想就是把网页内容当做对象来处理,通过对象的属性和方法对网页内容操作。
为什么需要这种思想?因为对象有属性、有方法,程序才能“查”和“改”。例如一个盒子在页面上是标签,在 DOM 里可以变成一个对象;你读取它的内容、替换它的文字,本质上是在操作这个对象。
怎么想?遇到 DOM 题目时先问自己三件事:我要操作谁?这个“谁”怎么获取成对象?我要改它的哪个属性或调哪个方法?转写稿里反复出现“先获取 DOM 对象,再操作对象属性”,就是这个推导过程。
怎么做?典型流程是:用 document 提供的方法获取元素对象,再用对象属性完成增、删、改、查。转写稿中演示过用 console.log 验证是否拿到元素,用 console.dir 展开对象查看属性,这都是调试手段。
易错点:不要一上来就写赋值,先确认对象拿到了没有;变量名、选择器写错时,对象可能是 null 或空伪数组,后面再改属性就会报错。
document 对象:网页内容的入口
笔记说:document 是 DOM 里提供的一个对象,是 DOM 顶级对象,作为网页内容的入口,所以它提供的属性和方法都是用来访问和操作网页内容的。例子是:
js
document.write()为什么需要 document?因为 JavaScript 要操作页面,总得有一个入口。document 就代表当前网页文档,通过它可以进一步获取元素、写入内容。
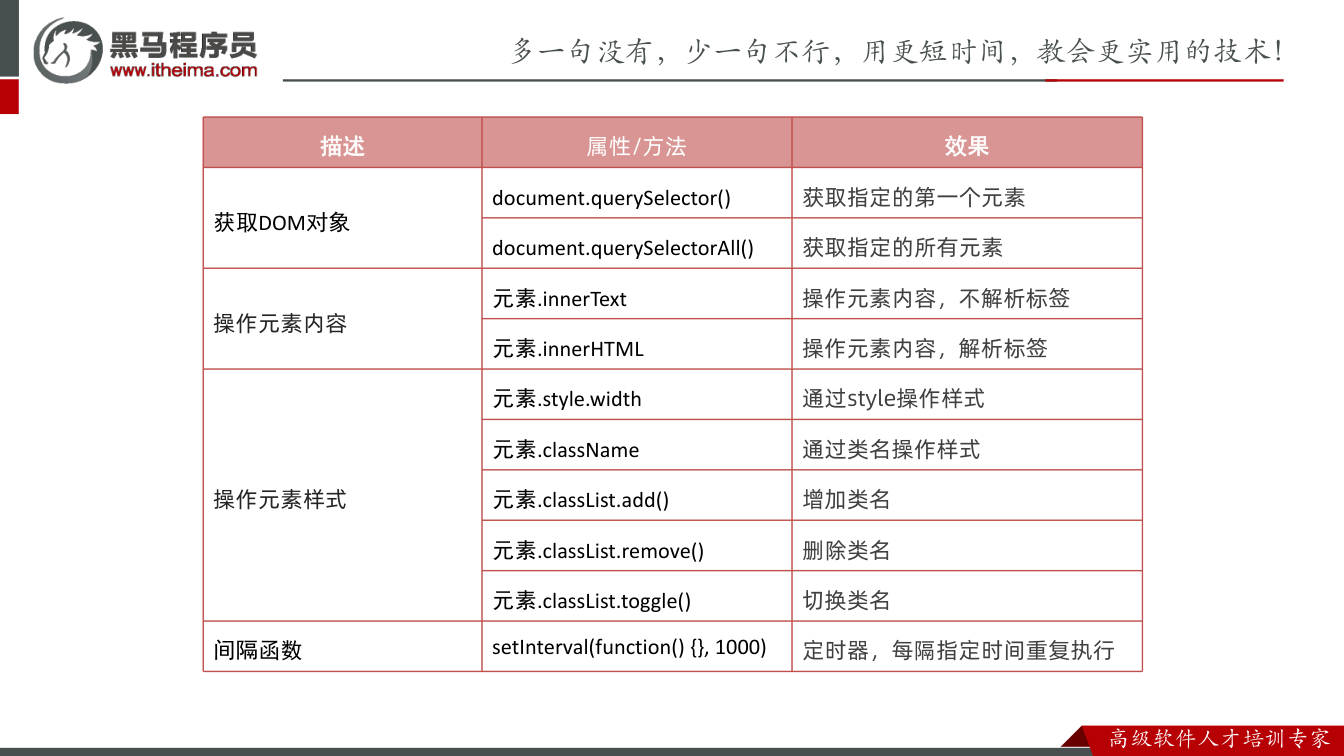
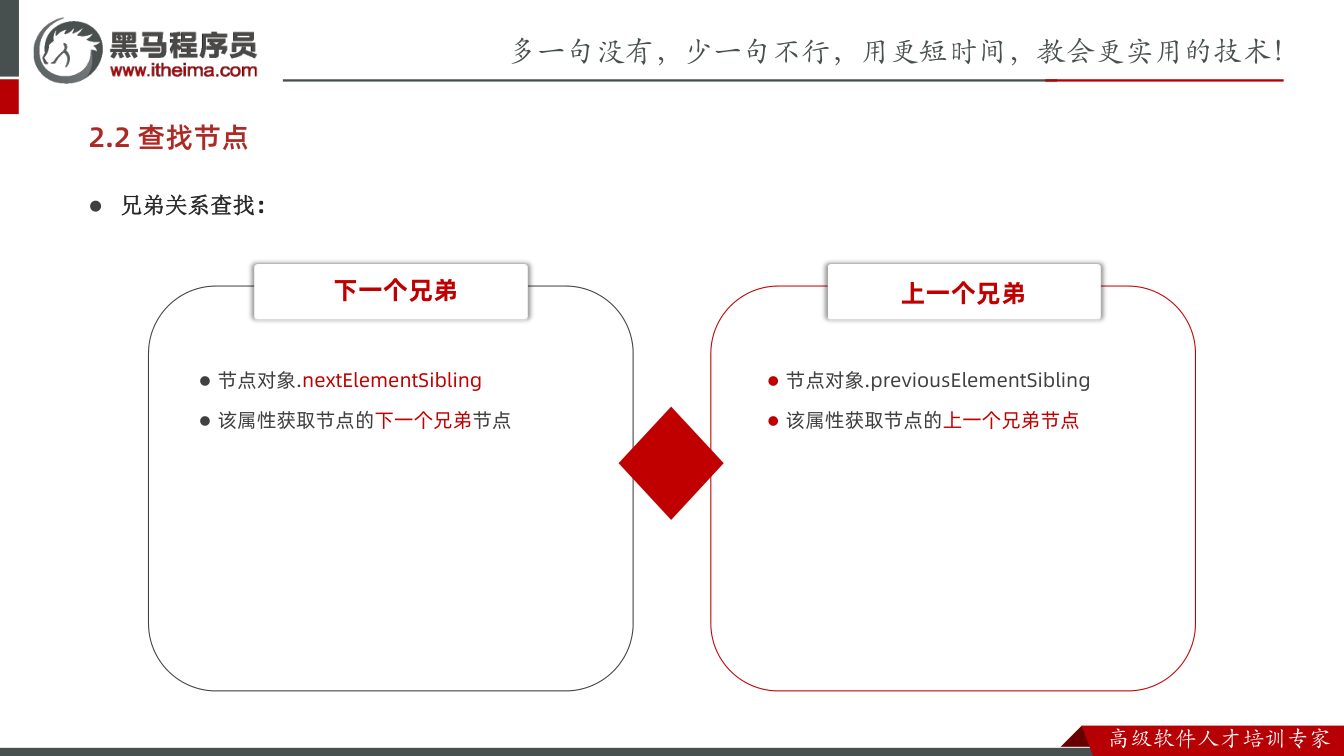
怎么想?可以把它理解成“页面的总对象”。要拿页面里的盒子、段落、输入框,通常都从 document 开始,例如 document.querySelector()、document.getElementById() 等。转写稿中还提到其他获取方式:getElementById、getElementsByClassName、getElementsByTagName、getElementsByName。其中 getElementById 按 ID 获取单个元素;其余几个通常返回伪数组。转写稿里口述的“尾数组”应纠正为“伪数组”。
怎么做?比如按 ID 获取时,参数直接写 ID 名,不写 #;按类名获取时,参数直接写类名,不写 .。这是转写稿调试时特别提醒的点。
易错点:document 是入口,不是某个具体盒子;不要把它和普通元素对象混在一起。获取多个元素时返回的是伪数组,不能直接当单个元素改 innerText。
从获取对象到操作内容:innerText 与 innerHTML
虽然本节笔记重点是 DOM 简介,但转写稿用“操作元素内容”说明了 DOM 的核心用法:先获取对象,再通过对象属性操作页面。常见两个属性是 innerText 和 innerHTML。
为什么需要它们?因为很多交互最终表现为“改盒子里的内容”。怎么想?如果只改纯文字,用 innerText;如果内容里包含标签并希望标签生效,用 innerHTML。怎么做?转写稿中的思路可以简化为:
js
const box = document.querySelector('.box')
console.log(box.innerText)          // 查
box.innerText = '迪丽热巴'           // 改
box.innerHTML = '<strong>迪丽热巴</strong>' // 解析标签转写稿还演示了“增”和“改”本质相同:给属性一个新值;“删”可以给空字符串。易错点:innerText 不解析标签,写 <strong> 会原样显示;innerHTML 会解析标签,所以能配合 CSS 做出加粗、变色等效果。复制代码时尤其要检查变量名和随机数编号,转写稿里就出现过复制二、三等奖代码后忘记改 random3 导致重复的调试过程。
调试与易错点:先验证,再修改
为什么需要调试?DOM 操作是“改对象影响页面”,一旦选择器或属性写错,页面不会按预期变化。怎么想?先验证对象是否存在,再验证属性值,最后看页面。怎么做?转写稿里的做法是先 console.log(box) 看是否拿到元素,再用 console.dir(box) 展开对象,找到 innerText、innerHTML 等属性,改完保存后到控制台和 Elements 面板确认。
易错点归纳:getElementById 参数不加 #;getElementsByClassName 参数不加 .;多个元素返回伪数组;innerText 不解析标签;删除内容给空字符串;复制代码要逐个改选择器、变量名和编号。掌握“先获取对象,再操作属性”的顺序,DOM 简介这一节就真正落地了。
先获取对象,才能操作页面
为什么需要:DOM 操作的本质是“先拿到元素对象,再改对象的属性”,对象改了,页面标签才会跟着变。
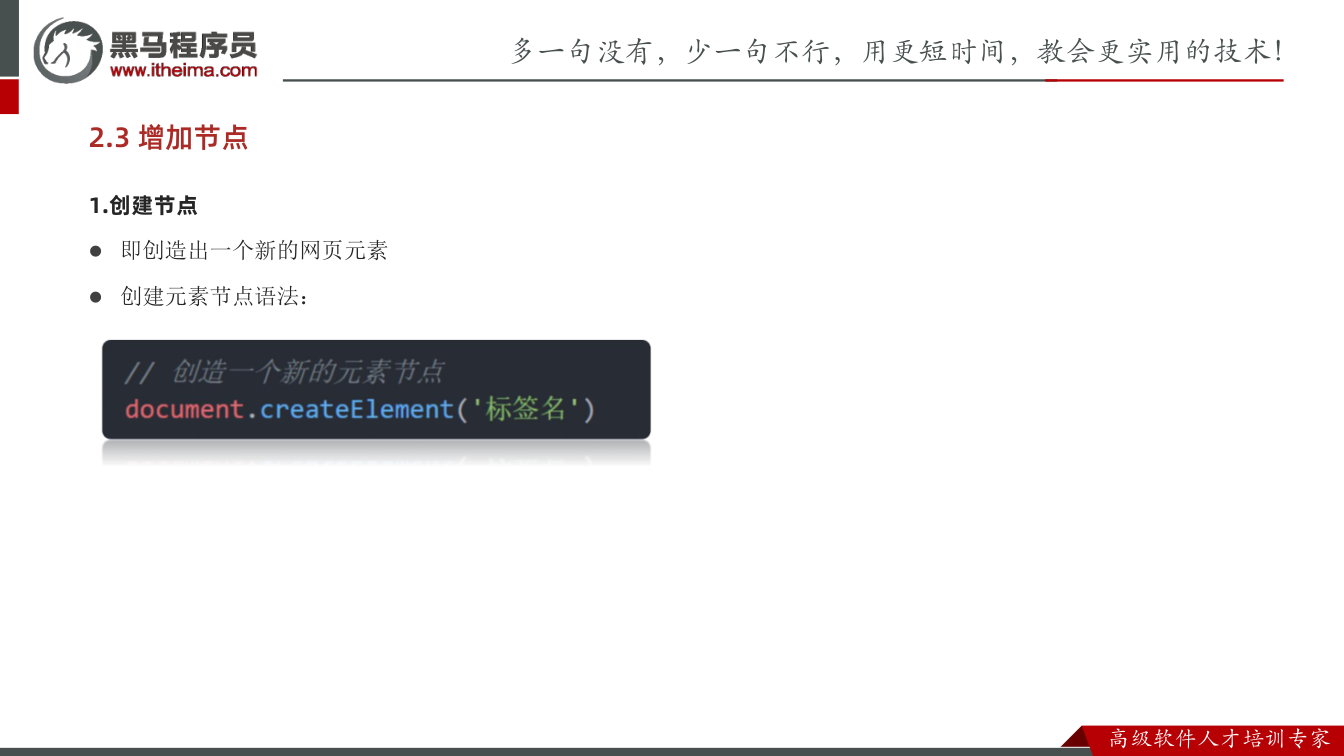
怎么想:把 document 当成入口,用 CSS 选择器去找元素;找第一个用 querySelector,找全部用 querySelectorAll。
怎么做:先写选择器字符串,再用 console.log 验证是否拿到;想详细看对象结构,用 console.dir(box)。
易错点:参数必须是字符串;匹配不到时返回 null,后面再点属性会报错;不要凭感觉写选择器,先打印验证。
利用 CSS 选择器获取第一个 DOM 元素
为什么需要:页面里常只要操作第一个匹配元素,例如第一个 div、列表里的第二个 li。
怎么想:querySelector 的规则和 CSS 选择器一致,CSS 怎么写,参数就怎么写。
怎么做:
javascript
// 利用css选择器来获取DOM元素
// 1. document.querySelector() 选择指定css选择器的第一个元素
// 1.1 参数是字符串的css选择器
const box = document.querySelector('div')
console.log(box)

// 1.2 返回值是dom对象
console.log(typeof box)  // object
console.dir(box)

const box = document.querySelector('.box')
console.log(box)

const li = document.querySelector('ol li')
console.log(li)   // 只选择满足条件的第一个元素li

const li = document.querySelector('ol li:nth-child(2)')
console.log(li)   // 选择第2个小li

// 1.3 如果获取不到则返回 null
const p = document.querySelector('p')
console.log(p) // null调试时可以先打印 box,确认是不是目标元素;再用 console.dir(box) 展开对象,观察 DOM 对象里的属性。
易错点:querySelector('ol li') 只拿第一个,不是全部;p 不存在时是 null,不是 undefined;示例代码分段演示,实际写在一起不要重复声明同名 const。
querySelectorAll 获取所有匹配元素
为什么需要:列表、导航、多个卡片等场景要一次拿到全部匹配项。
怎么想:返回值不是普通数组,而是 NodeList 伪数组;伪数组有长度和索引,但没有 push、pop、splice 等数组方法。
怎么做:
javascript
// 2. document.querySelectorAll() 选择指定css选择器的所有元素
// 2.1 参数还是字符串的css选择器
const lis = document.querySelectorAll('.nav li')

// 2.2 返回值是一个伪数组里面包含了所有的dom对象 li
console.log(lis)

// 2.3 伪数组
// (1) 有长度和索引号
// (2) 没有数组的一些常用方法 比如 push  pop  splice等方法
// lis.push(1)
// console.log(lis)  // 因为lis是伪数组无法使用push方法所以报错

// 2.4 利用循环遍历伪数组得到里面的每一个元素对象
for (let i = 0; i < lis.length; i++) {
  console.log(lis[i]) // 里面的每一个元素对象
}

// 2.5 即使只有1个元素,我们querySelectorAll 获得的也是一个伪数组,里面只有1个元素而已

const boxs = document.querySelectorAll('.box')
console.log(boxs)调试时若执行 lis.push(1) 报错,正好说明它是伪数组;要操作每一项,用 for 循环按索引取。
易错点:不要直接对 querySelectorAll 结果用数组方法;即使只匹配一个元素,它仍然返回伪数组。
其他获取方式(了解)
为什么需要:读旧项目或别人代码时,要能认出这些写法。
怎么想:按 id 获取单个元素;按类名、标签名、name 属性获取通常是伪数组。
怎么做:
| 语法 | 实例 | 描述 |
|---|---|---|
| getElementById | document.getElementById('box') | 根据id获取元素,单个元素 |
| getElementsByTagName | document.getElementsByTagName('li') | 根据标签名获取元素,伪数组 |
| getElementsByClassName | document.getElementsByClassName('one') | 根据类名获取元素,伪数组 |
| getElementsByName | document.getElementsByName('sex') | 根据name属性值获取元素,伪数组 |
javascript
// 1. getElementById   根据id获取
const box = document.getElementById('box')
console.log(box)

// 2. getElementsByClassName   根据类名获取  返回伪数组
const items = document.getElementsByClassName('item')
console.log(items)

// 3. getElementsByTagName  根据标签名获取 返回伪数组
const ps = document.getElementsByTagName('p')
console.log(ps)

// 4. getElementsByName  根据name属性获取 返回伪数组
const inputs = document.getElementsByName('username')
console.log(inputs)转写稿里的调试过程是:getElementById('box') 能拿到 id 盒子,注意参数不加 #;getElementsByClassName('item') 拿到三个元素的伪数组,类名不加点;getElementsByTagName('p') 返回伪数组;getElementsByName('username') 即使只匹配一个 input,返回的仍是伪数组。
易错点:getElementById 只返回单个元素,参数不加 #;getElementsByClassName 参数不加 .;带 s 的 getElements... 通常返回伪数组,不能当普通数组直接用。
课件图示
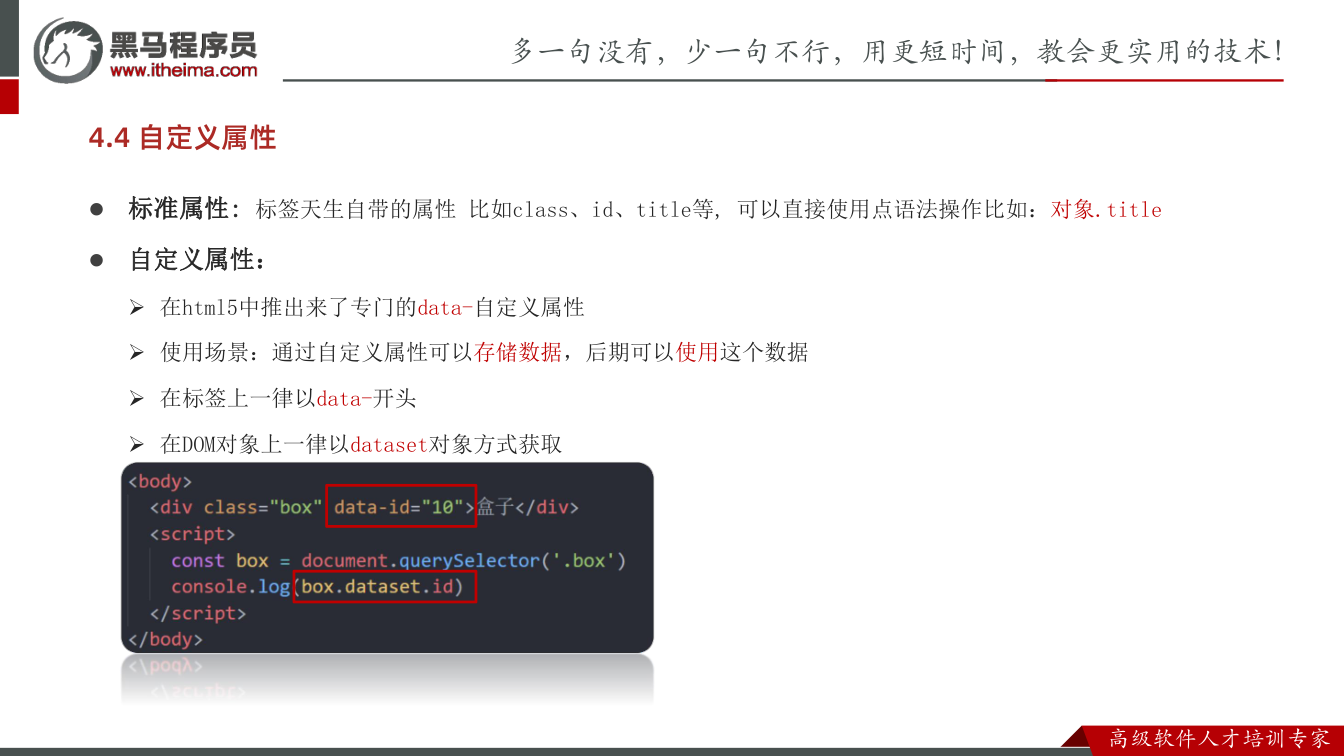
代码示例
示例一:获取 DOM 对象 + 操作元素内容(innerText / innerHTML)
html
<!DOCTYPE html>
<html lang="zh-CN">
<head>
  <meta charset="UTF-8">
  <title>获取DOM对象与操作元素内容</title>
  <style>
    .box  { width: 200px; height: 50px; line-height: 50px; background: #eee; margin-bottom: 10px; }
    .box1 { width: 200px; height: 50px; line-height: 50px; background: #ddf; margin-bottom: 10px; }
  </style>
</head>
<body>
  <div class="box">鼓励占拉</div>
  <div class="box1"></div>

  <ol class="nav">
    <li>第1个小li</li>
    <li>第2个小li</li>
    <li>第3个小li</li>
  </ol>

  <script>
    // ===== 1. querySelector:选择指定css选择器的第一个元素 =====
    const box = document.querySelector('.box')
    console.log(box)              // 拿到第一个匹配的元素对象
    console.log(typeof box)       // object —— 返回的是 dom 对象
    console.dir(box)              // 以对象形式展开查看属性

    const li = document.querySelector('ol li')                  // 只选第一个 li
    console.log(li)
    const li2 = document.querySelector('ol li:nth-child(2)')    // 选第2个 li
    console.log(li2)

    // 获取不到则返回 null
    const p = document.querySelector('p')
    console.log(p)                // null

    // ===== 2. querySelectorAll:选择指定css选择器的所有元素 =====
    const lis = document.querySelectorAll('.nav li')
    console.log(lis)              // 伪数组 NodeList,有 length 和索引号
    // lis.push(1)                // 报错!伪数组没有 push / pop / splice 等方法

    for (let i = 0; i < lis.length; i++) {
      console.log(lis[i])         // 循环遍历伪数组,拿到每一个元素对象
    }

    // 即使只有1个元素,querySelectorAll 得到的也是伪数组
    const boxs = document.querySelectorAll('.box')
    console.log(boxs)

    // ===== 3. 操作元素内容:查、改、增、删 =====
    console.log(box.innerText)          // 查:鼓励占拉
    box.innerText = '迪丽热巴'           // 改:用新值替换旧值

    const box1 = document.querySelector('.box1')
    box1.innerText = '佟丽娅'            // 增:原来没内容,给新值即新增

    // box.innerText = ''               // 删:给空字符串即清空内容
    // box1.innerText = ''

    // ===== 4. innerText 不能解析标签 =====
    box.innerText = '<strong>迪丽热巴</strong>'   // 标签被原样显示,不会加粗

    // ===== 5. innerHTML 能解析标签 =====
    box.innerHTML = '<strong>迪丽热巴</strong>'   // 加粗生效
  </script>
</body>
</html>关键行与易错点
document.querySelector('.box'):参数是字符串形式的 CSS 选择器,类名要写.、id 要写#;匹配不到返回null,后续直接点属性会报错。document.querySelectorAll()返回的是伪数组 NodeList,只能用length和索引号遍历,不能调用push、splice等数组方法;即使只匹配到一个,也是伪数组。innerText是内部文本的意思,只能渲染纯文本,不解析标签——写<strong>会把标签原样显示出来。innerHTML用法与innerText完全一致,但会解析标签;HTML四个字母必须全大写。- 增、改、删本质都是"给属性赋新值":新值替换旧值是改,原本为空给新值是增,给空字符串
''就是删。 - 顺序不能颠倒:先获取 DOM 对象,再通过"对象.属性"操作内容;对象修改后,页面标签会自动跟着变。
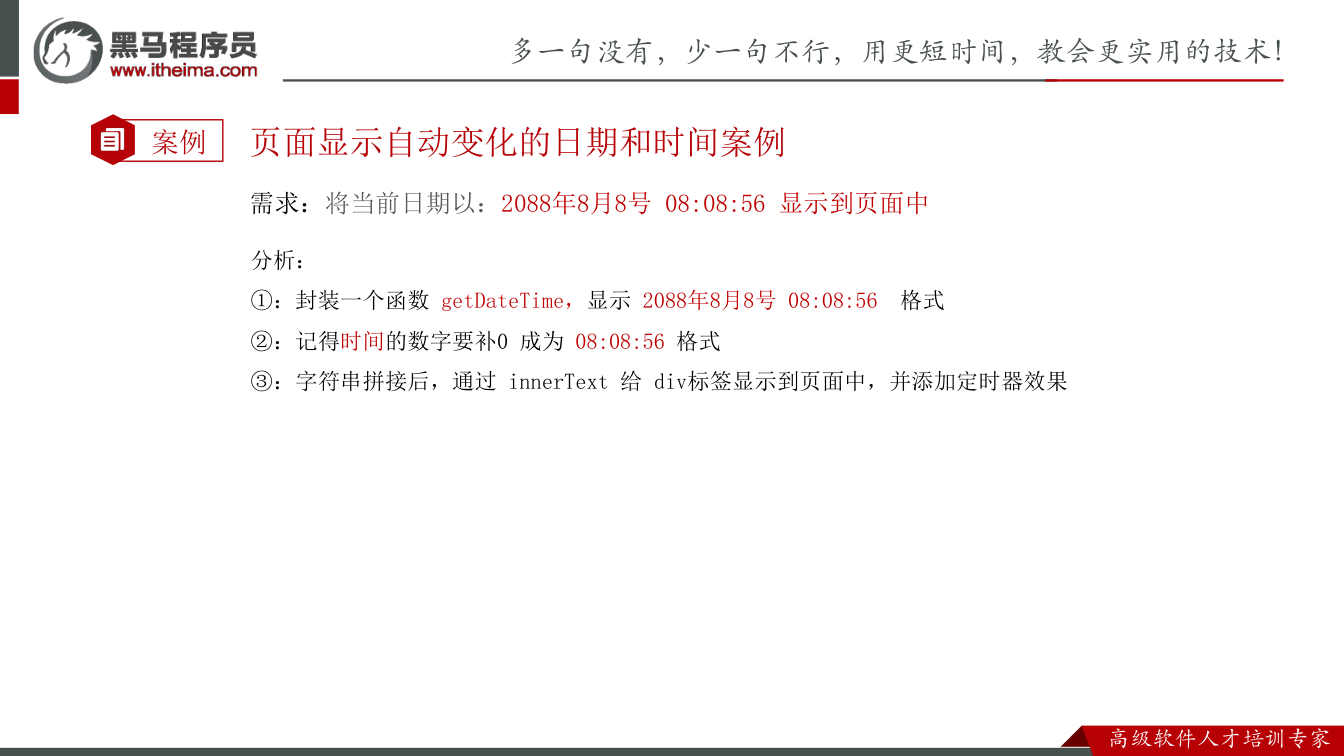
示例二:重构学成在线案例(循环拼接字符串 + innerHTML)
js
<!DOCTYPE html>
<html lang="zh-CN">
<head>
  <meta charset="UTF-8">
  <title>重构学成在线案例</title>
  <style>
    .box { width: 600px; margin: 50px auto; }
    .box-hd {
      height: 60px; line-height: 60px; text-align: center;
      font-size: 20px; background: #f5f5f5;
    }
    .common { display: flex; flex-wrap: wrap; list-style: none; padding: 0; margin: 0; }
    .common li { width: 33.33%; box-sizing: border-box; padding: 10px; }
    .common li a { display: block; text-decoration: none; color: #333; }
    .common li .pic {
      height: 60px; line-height: 60px; text-align: center; background: pink;
    }
  </style>
</head>
<body>
  <!-- 页面结构:不变的 hd 直接写在 html 里,只有 ul 里的 li 需要动态渲染 -->
  <div class="box">
    <div class="box-hd">学成在线</div>
    <div class="box-bd">
      <ul class="common"></ul>
    </div>
  </div>

  <script>
    // 1. 准备数据(11 条,比原来多加了一条)
    const data = [1, 2, 3, 4, 5, 6, 7, 8, 9, 10, 11]

    // 2. 利用循环生成多个 li 标签,用字符串拼接
    let str = ''                          // 必须用 let,循环中会反复重新赋值
    for (let i = 0; i < data.length; i++) {
      str += `<li>
                <a href="#">
                  <div class="pic">课程${data[i]}</div>
                  <h4>学成在线 - 课程${data[i]}</h4>
                </a>
              </li>`
    }
    console.log(str)

    // 3. 获取 li 的父亲 ul
    const ul = document.querySelector('.common')

    // 4. 把拼接好的字符串作为元素内容放入 ul
    ul.innerHTML = str                    // 只能用 innerHTML,因为字符串里包含标签
  </script>
</body>
</html>关键行与易错点
- 只把会变化的部分交给 JS 渲染:
box-hd和ul外壳不变,直接写在 HTML 中,不再用document.write把整页打印一遍。 let str = ''必须用let:循环中str += ...反复重新赋值,写成const会报错。for循环里的let i也不能改成const,因为i每次循环都会变化。- 第 4 步必须用
innerHTML而不是innerText:拼接出来的字符串中包含<li>、<a>、<div>等标签,需要被浏览器解析成真正的元素。 - 顺序是"先获取盒子,再往里塞内容";
ul在循环结束后只获取一次即可,不要放进循环里重复获取。 - 这种"先拼字符串 → 再 innerHTML 赋值"的两步思路,是以后渲染列表数据的常用写法。
示例三:年会抽奖案例(一等奖、二等奖、三等奖)
html
<!DOCTYPE html>
<html lang="zh-CN">
<head>
  <meta charset="UTF-8">
  <title>年会抽奖</title>
  <style>
    .wrapper {
      width: 400px; margin: 50px auto; padding: 20px;
      background: #fdf1f1; text-align: center;
    }
    .wrapper strong { display: block; font-size: 22px; margin-bottom: 10px; }
    h1, h3, h5 { margin: 10px 0; }
    span { color: pink; }
  </style>
</head>
<body>
  <div class="wrapper">
    <strong>年会抽奖</strong>
    <h1>一等奖:<span class="one">???</span></h1>
    <h3>二等奖:<span class="two">???</span></h3>
    <h5>三等奖:<span class="three">???</span></h5>
  </div>

  <script>
    const arr = ['迪丽热巴', '马尔扎哈', '鼓励占拉', '佟丽娅']

    // ===== 一等奖 =====
    // 1.1 利用随机数选取数组中的名字
    const random = Math.floor(Math.random() * arr.length)
    console.log(random, arr[random])

    // 1.2 把名字放入对应的盒子
    const one = document.querySelector('.one')
    one.innerText = arr[random]        // 只放文字,用 innerText 即可

    // 1.3 不允许重复抽奖,把抽出的名字从数组中删除
    arr.splice(random, 1)
    console.log(arr)

    // ===== 二等奖(做法与一等奖完全一致)=====
    const random2 = Math.floor(Math.random() * arr.length)
    const two = document.querySelector('.two')
    two.innerText = arr[random2]
    arr.splice(random2, 1)
    console.log(arr)

    // ===== 三等奖 =====
    const random3 = Math.floor(Math.random() * arr.length)
    const three = document.querySelector('.three')
    three.innerText = arr[random3]
    arr.splice(random3, 1)
    console.log(arr)
  </script>
</body>
</html>关键行与易错点
Math.floor(Math.random() * arr.length)生成0 ~ arr.length-1的随机整数,正好作为数组的索引号;每删掉一个人,arr.length会自动变小,第二次抽取自然只从剩下的 3 个里抽。- 随机数变量用
const没问题,因为它声明后没有再被重新赋值;但如果写成let之后再重新赋值,也不能改成const。 arr.splice(random, 1)的两个参数含义:从哪个索引开始删、删几个。第一个参数必须用刚抽中的random,删 1 个,才能保证抽过的人不会再出现在后面的奖项里。- 最容易出错的地方是复制代码后忘记改变量名:二等奖要用
random2/.two,三等奖要用random3/.three,写串了会出现重复中奖或某个奖项一直是???。 innerText与innerHTML这里都可以,因为只放纯文字、不涉及标签;养成"有标签用 innerHTML,纯文字用 innerText"的习惯即可。
常见错误
- 现象:
querySelector('box')选不到元素。 → 原因: 参数必须是合法 CSS 选择器字符串,类名漏写.。 → 修法: 改为querySelector('.box'),并在控制台先验证返回值是否为null。 - 现象:
querySelectorAll的结果调用push报错。 → 原因: 返回的是 NodeList 伪数组,没有数组常用方法。 → 修法: 用for循环按索引遍历;确需数组方法时先转换再使用。 - 现象:用
innerText写入<strong>文字</strong>,页面直接显示标签原文。 → 原因:innerText不解析标签。 → 修法: 需要标签生效时改用innerHTML,并确认HTML全大写。 - 现象:抽奖删除时写成
arr.splice(name, 1),结果删错或不删。 → 原因:splice第一个参数是起始索引,不是姓名。 → 修法: 用抽中的随机索引删除,如arr.splice(random, 1)。 - 现象:复制二等奖代码做三等奖,页面出现重复姓名或写错位置。 → 原因: 复制后未同步修改
random2、to、three等变量和选择器。 → 修法: 逐项改随机数变量、目标盒子类名、删除索引用量,并刷新多次验证。 - 现象:
querySelectorAll('.box')明明只匹配一个元素,却直接写boxs.innerText无效。 → 原因: 返回的仍是伪数组,不是单个 DOM 对象。 → 修法: 用boxs[0]取到元素后再操作。 - 现象:
const声明的拼接字符串或随机数被重新赋值时报错。 → 原因:const不允许重新赋值。 → 修法: 循环中会反复赋值的变量用let;确认不再重新赋值再用const。
练习
- 使用
querySelector获取页面中第一个.box,再用querySelectorAll获取所有.nav li,用循环输出每个li的文本内容。 - 准备两个空盒子,分别用
innerText和innerHTML写入包含<strong>的姓名内容,观察并说明两者显示差异。 - 根据给定数组生成多个
li字符串,获取目标ul,用innerHTML一次性渲染到页面中。 - 完成年会抽奖一等奖逻辑:随机抽取数组中的一个姓名写入指定
span,并把该姓名从数组中删除,保证后续不会重复中奖。 - 找错并修正:
const lis = document.querySelectorAll('li'); lis.push(document.querySelector('li'));以及box.innerHTML = '<strong>测试</strong>';中可能存在的书写与使用问题。
原视频对照
| # | 视频 | 时长 |
|---|---|---|
| 1 | 其他方式获取DOM元素 | 04:26 |
| 2 | 操作元素内容innerText和innerHTML | 13:21 |
| 3 | 重构学成在线案例 | 07:05 |
| 4 | 年会抽奖案例-一等奖做法 | 11:52 |
| 5 | 年会抽奖案例-二三等奖做法 | 04:42 |
小结
- 操作元素前先获取到正确的 DOM 对象,选择器字符串写错时优先检查返回值是否为
null。 - 单个元素与元素集合要分清:
querySelector取第一个,querySelectorAll始终得到伪数组。 - 只改文字优先考虑
innerText;需要让标签生效时使用innerHTML。 - 批量渲染列表时,先拼字符串,再获取目标容器,用
innerHTML一次性写入更简洁。 - 抽奖类需求的关键是“随机索引、写入对应盒子、按同一索引删除”,三步要保持一致。
- 复制代码后必须逐项核对变量名、选择器和索引,复制不改是高频错误来源。
- 变量声明按是否重新赋值选择
const或let,循环拼接和随机数复用时尤其要注意。 - 调试时多用
console.log看值、console.dir看对象结构,先验证再继续写。