主题
2-17综合案例-学生统计表案例(一)
本页对应 第二章WebAPIs,共 6 段视频,约 48 分钟。
学习目标
- 能独立分析“学生就业统计表”页面的表单、统计条数、表格及删除按钮等结构,并说明渲染、新增、删除三个业务的数据流。
- 能使用
localStorage.setItem、localStorage.getItem配合JSON.stringify、JSON.parse完成对象数组的持久化读取,并在无数据时使用空数组兜底。 - 能说明
map与join的作用和返回值差异,并使用map遍历数组生成tr字符串、使用join('')拼接后插入tbody。 - 能封装
render渲染函数,根据数组长度更新统计条数,并完成页面数据的重新渲染。 - 能给
form注册submit事件,使用事件对象阻止默认提交行为,并对姓名、年龄、薪资完成非空判断与提示。 - 能使用正则表达式完成字符串替换,并正确使用相关修饰符实现指定匹配与替换效果。
知识点
说明
本节转写稿实际讲的是“学生就业统计表”综合案例,涉及本地存储、map、join 等,与“正则表达式”不是同一主题;为避免编造,下面不把综合案例硬套进正则,只依据笔记中的正则代码与注释做推导和调试说明。转写稿中“本机存储/本底存储”应写作“本地存储”,“飞空判断”应写作“非空判断”,“m普/卖铺”应写作“map”,“招人方法”应写作“join方法”。
正则表达式是什么
为什么需要:表单验证、敏感词替换、从字符串中提取特定部分,都需要一种“描述字符串规则”的工具。怎么想:把规则写成模式,再用模式去匹配字符串。怎么做:正则表达式是字符串匹配的模式,也是对象。使用场景包括手机号只能输入 11 位数字的匹配、敏感词替换、提取目标内容等。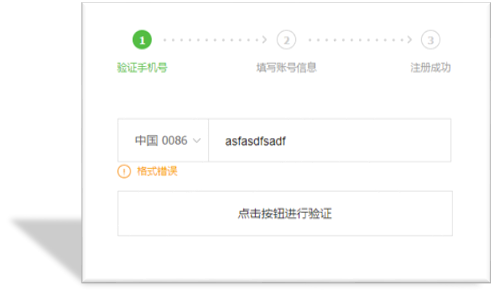
易错点:不要把正则当成普通字符串;它描述的是“规则”,不是固定的一段文本。
基本使用:定义规则与 test()
为什么需要:先有规则,才能判断字符串是否符合。怎么想:用 /表达式/ 定义字面量,再调用 test() 查看是否匹配。怎么做:
html
<body>
  <script>
    // 正则表达式的基本使用
    const str = 'web前端开发'
    // 1. 定义规则
    const reg = /web/

    // 2. 使用正则  test()
    console.log(reg.test(str))  // true  如果符合规则匹配上则返回true
    console.log(reg.test('java开发'))  // false  如果不符合规则匹配上则返回 false
  </script>
</body>按代码调试:str 中包含 web,所以第一次返回 true;'java开发' 不含 web,返回 false。易错点:test() 返回布尔值;/ / 是正则字面量,不是普通括号。
普通字符与元字符
为什么需要:普通字符只能匹配自身,写 26 个字母很麻烦;元字符能提高灵活性和匹配能力。怎么想:普通字符如字母、数字只描述自己;元字符有特殊含义。怎么做:例如匹配英文 26 个字母,普通字符写法是 /[abcdefghijklmnopqrstuvwxyz]/,元字符写法可写成 /[a-z]/。易错点:元字符不是“更高级的普通字符”,它的含义由正则语法决定。
边界符:^ 和 $
为什么需要:只判断“包含”不够,还要限定开头、结尾或精确匹配。怎么想:^ 提示开头位置,$ 提示结束位置;二者一起表示精确匹配。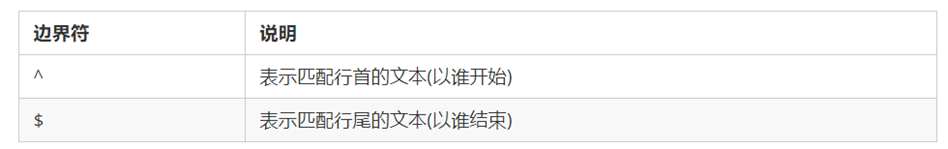
怎么做:
html
<body>
  <script>
    // 元字符之边界符
    // 1. 匹配开头的位置 ^
    const reg = /^web/
    console.log(reg.test('web前端'))  // true
    console.log(reg.test('前端web'))  // false
    console.log(reg.test('前端web学习'))  // false
    console.log(reg.test('we'))  // false

    // 2. 匹配结束的位置 $
    const reg1 = /web$/
    console.log(reg1.test('web前端'))  //  false
    console.log(reg1.test('前端web'))  // true
    console.log(reg1.test('前端web学习'))  // false
    console.log(reg1.test('we'))  // false

    // 3. 精确匹配 ^ $
    const reg2 = /^web$/
    console.log(reg2.test('web前端'))  //  false
    console.log(reg2.test('前端web'))  // false
    console.log(reg2.test('前端web学习'))  // false
    console.log(reg2.test('we'))  // false
    console.log(reg2.test('web'))  // true
    console.log(reg2.test('webweb'))  // flase
  </script>
</body>易错点:/^web/ 只要求开头是 web;/web$/ 只要求结尾是 web;/^web$/ 才要求整个字符串就是 web。
量词:重复次数
为什么需要:很多规则不是“有没有”,而是“重复几次”,如 11 位手机号。怎么想:用 *、+、?、{n}、{n,}、{n,m} 控制前一个模式重复次数。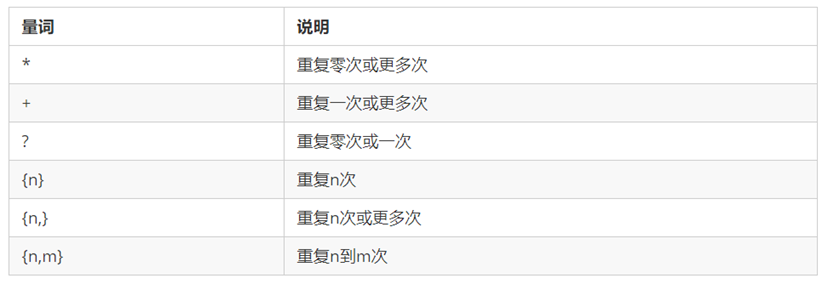
怎么做:
html
<body>
  <script>
    // 元字符之量词
    // 1. * 重复次数 >= 0 次
    const reg1 = /^w*$/
    console.log(reg1.test(''))  // true
    console.log(reg1.test('w'))  // true
    console.log(reg1.test('ww'))  // true

    // 2. + 重复次数 >= 1 次
    const reg2 = /^w+$/
    console.log(reg2.test(''))  // false
    console.log(reg2.test('w'))  // true
    console.log(reg2.test('ww'))  // true

    // 3. ? 重复次数  0 || 1
    const reg3 = /^w?$/
    console.log(reg3.test(''))  // true
    console.log(reg3.test('w'))  // true
    console.log(reg3.test('ww'))  // false

    // 4. {n} 重复 n 次
    const reg4 = /^w{3}$/
    console.log(reg4.test('www'))  // true
    console.log(reg4.test('wwww'))  // false

    // 5. {n,} 重复次数 >= n
    const reg5 = /^w{2,}$/
    console.log(reg5.test('w'))  // false
    console.log(reg5.test('ww'))  // true

    // 6. {n,m}   n =< 重复次数 <= m
    const reg6 = /^w{2,4}$/
    console.log(reg6.test('w'))  // false
    console.log(reg6.test('wwww'))  // true
    console.log(reg6.test('wwwww'))  // false
  </script>
</body>易错点:{n,m} 的逗号左右千万不要出现空格,否则匹配失败。
范围:[ ] 与取反
为什么需要:限定字符只能来自某个范围,如字母、数字、下划线。怎么想:[abc] 表示多选一;[a-z] 表示范围;[^a-z] 表示取反。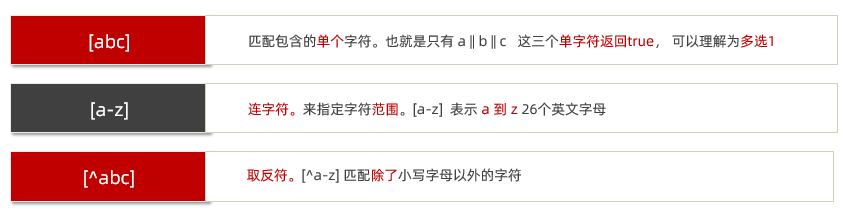
怎么做:
html
<body>
  <script>
    // 元字符之范围  []
    // 1. [abc] 匹配包含的单个字符, 多选1
    const reg1 = /^[abc]$/
    console.log(reg1.test('a'))  // true
    console.log(reg1.test('ab'))  // false

    // 2. [a-z] 连字符 单个
    const reg2 = /^[a-z]$/
    console.log(reg2.test('a'))  // true
    console.log(reg2.test('A'))  // false

    const reg3 = /^[a-zA-Z0-9]$/
    console.log(reg3.test('B'))  // true
    console.log(reg3.test(9))  // true
    console.log(reg3.test(','))  // flase

    // 用户名可以输入英文字母,数字,可以加下划线,要求 6~16位
    const reg4 = /^[a-zA-Z0-9_]{6,16}$/
    console.log(reg4.test('abcd1'))  // false
    console.log(reg4.test('abcd12'))  // true
    console.log(reg4.test('ABcd12_'))  // true

    // 3. [^a-z] 取反符
    const reg5 = /^[^a-z]$/
    console.log(reg5.test('a'))  // false
    console.log(reg5.test('A'))  // true
  </script>
</body>易错点:[ ] 通常只匹配一个字符;[^a-z] 的 ^ 在方括号内表示取反,不是开头边界符。
字符类
为什么需要:常见模式如字母、数字、空白等反复书写麻烦,字符类提供简写方式。怎么想:把常见字符集合记成简写,区分字母和数字。怎么做:结合下图记忆常见简写。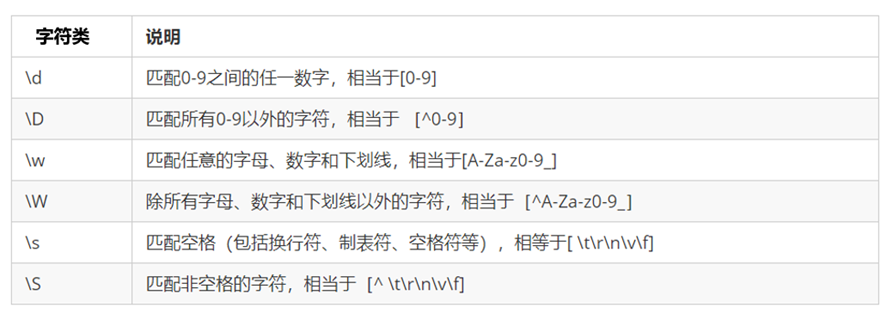
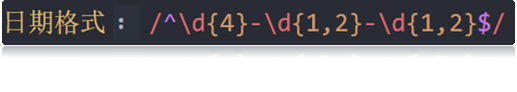
易错点:字符类简写有大小写之分,含义不同;不要和普通字符、范围符混用。
替换方法 replace:为什么需要与基本思路
为什么需要:字符串中经常要把某个词替换成另一个词,例如把“前端”统一改成“web”。如果手动查找再拼接,代码既长又容易漏改。replace 就是用来完成“查找并替换”的方法。
怎么想:先明确两件事:要替换的目标是什么、替换成什么。笔记中的目标是“前端”,替换内容是“web”。再考虑是只替换第一个,还是替换全部;这由正则和修饰符决定。
怎么做:replace 的返回值是替换完毕的新字符串,原字符串本身不会改变。基本形式是:
html
<body>
  <script>
    // 替换和修饰符
    const str = '欢迎大家学习前端,相信大家一定能学好前端,都成为前端大神'
    // 1. 替换  replace  需求:把前端替换为 web
    // 1.1 replace 返回值是替换完毕的字符串
    // const strEnd = str.replace(/前端/, 'web') 只能替换一个
  </script>
</body>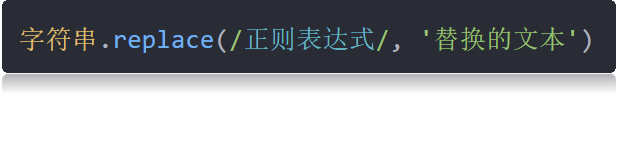
易错点:不要以为写了 replace 就会自动替换全部。上面注释掉的代码 /前端/ 没有修饰符,只会替换第一个“前端”。另外要接住返回值,不能只写 str.replace(...) 却不使用结果。
只替换第一个:易错点与调试
为什么需要:很多同学第一次用 replace 时,发现字符串里明明有多个“前端”,结果只变了一个。这不是方法失效,而是默认只替换第一个匹配项。
怎么想:先观察原字符串里有几个“前端”,再观察返回值里变了几个。用控制台打印结果,比只看代码更可靠。转写稿里反复强调“先测试、看控制台、再改代码”的调试习惯,这里同样适用:先验证 replace 的返回值,再决定是否加修饰符。
怎么做:保留笔记中的测试代码,先不取消注释,理解“只能替换一个”的现象;再对比下面加 g 的结果。
易错点:把 replace 当成“自动全局替换”;或者把 g 写到正则外面、写错位置。修饰符要写在正则字面量最后一条斜杠的后面,如 /前端/g。
修饰符 g:全部替换
为什么需要:需求是把所有“前端”都替换成“web”,只替换第一个显然不够。g 是单词 global 的缩写,表示匹配所有满足正则表达式的结果。
怎么想:在正则后面加 g,让 replace 找到全部匹配项并逐一替换。返回值仍是替换完毕的字符串。
怎么做:笔记中的完整代码是:
html
<body>
  <script>
    // 替换和修饰符
    const str = '欢迎大家学习前端,相信大家一定能学好前端,都成为前端大神'
    // 1. 替换  replace  需求:把前端替换为 web
    // 1.1 replace 返回值是替换完毕的字符串
    // const strEnd = str.replace(/前端/, 'web') 只能替换一个

    // 2. 修饰符 g 全部替换
    const strEnd = str.replace(/前端/g, 'web')
    console.log(strEnd)
  </script>
</body>易错点:g 只影响“是否全局匹配”,不负责忽略大小写;如果还需要忽略大小写,要再写 i。另外,g 是修饰符,不是替换内容的一部分。
修饰符 i:忽略大小写
为什么需要:正则匹配时,有时希望字母不区分大小写。笔记明确说明:i 是单词 ignore 的缩写,正则匹配时字母不区分大小写。
怎么想:如果目标文本里可能出现大小写不同的写法,就加 i。例如英文场景中,匹配 hello 时希望 Hello 也能命中,就需要 i。中文本身没有大小写,所以 i 更多用于英文或混合文本。
怎么做:把 i 写在正则字面量后面;如果需要“忽略大小写且全部替换”,就组合成 gi 或 ig。例如思路是 /目标/gi,再交给 replace。
易错点:以为 i 能解决“只替换一个”的问题;其实 i 管大小写,g 管全部匹配,两者职责不同。
修饰符组合与常见易错点
为什么需要:真实需求常常同时要求“不区分大小写”和“全部替换”,只加一个修饰符不够。
怎么想:先判断是否需要忽略大小写,再判断是否需要全部替换。两个都需要,就组合修饰符。顺序通常写 gi 即可。
怎么做:在正则字面量最后加 gi,例如 /前端/gi。如果只替换第一个但忽略大小写,用 i;如果全部替换但区分大小写,用 g。
易错点:把修饰符写到字符串参数里;或者把 replace 的第二个参数写错位置。replace 的第一个参数是匹配规则,第二个参数是替换成的内容。
调试与验证:从笔记代码到可观察结果
为什么需要:只看代码容易误判“到底替换了几个”。转写稿中的调试过程强调先准备数据、再打印结果、最后观察页面或控制台;本节也应先打印 strEnd,对比原字符串。
怎么想:先运行只替换一个的版本,观察结果;再改成 /前端/g,观察是否全部替换;最后思考如果加 i,匹配行为会怎样变化。每次只改一个条件,便于定位。
怎么做:用 console.log(strEnd) 查看返回值;同时可打印原字符串 str,确认原字符串没有被修改。若结果不符合预期,先检查正则后面有没有 g,再检查是否把返回值赋给了变量。
易错点:只打印原字符串,不打印返回值;或者误以为 replace 会直接修改 str。记住:replace 返回替换后的新字符串,原字符串保持不变。
小结
本节的核心是 replace 与修饰符:replace 完成替换并返回新字符串;不加 g 只替换第一个;g 表示全局匹配;i 表示忽略大小写;需要同时满足时可组合使用。写代码时先明确需求,再选择修饰符,最后用控制台验证替换结果,避免把“只替换一个”误当成方法错误。
课件图示
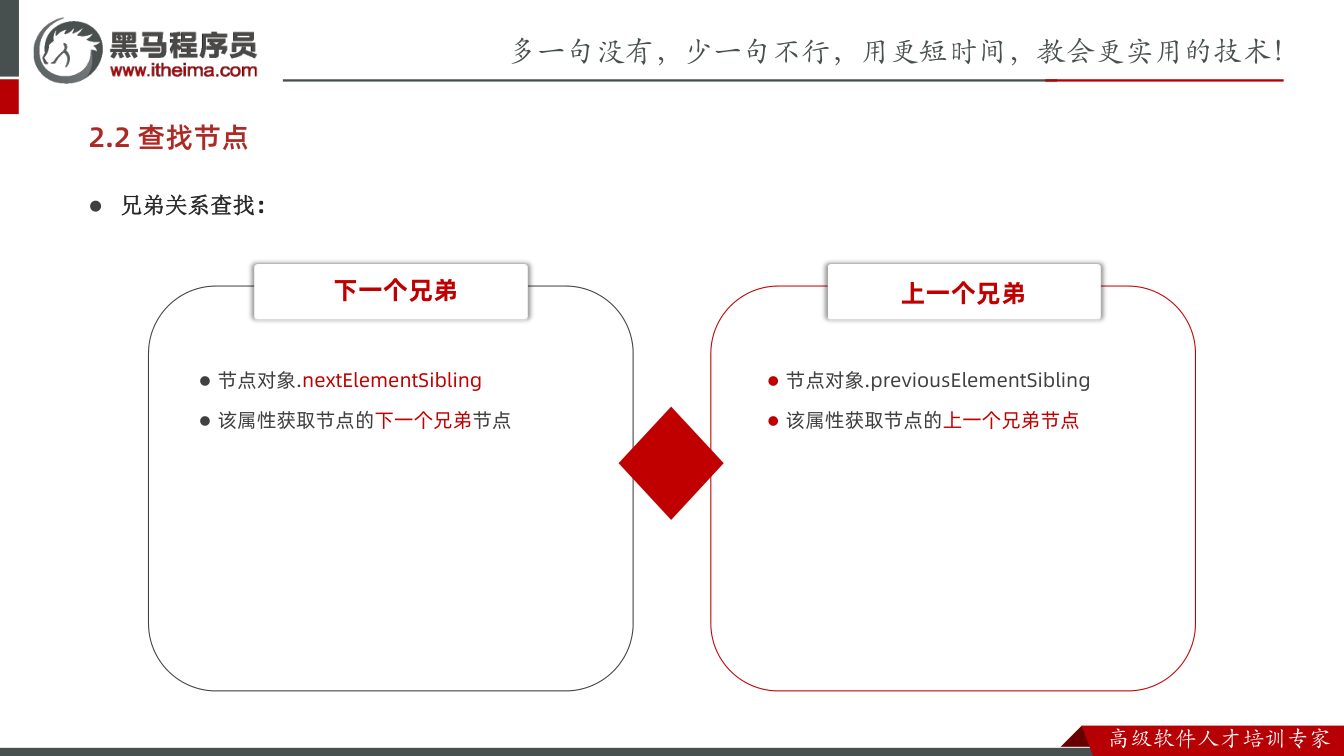
代码示例
示例 1:正则表达式基本使用(test / 边界符 / 量词 / 范围)
html
<body>
  <script>
    // ================= 1. 正则的基本使用 =================
    const str = 'web前端开发'
    // 定义规则:/表达式/ 是正则字面量,正则也是对象
    const reg = /web/
    // test() 用来检测正则与字符串是否匹配,匹配返回 true,否则 false
    console.log(reg.test(str))         // true
    console.log(reg.test('java开发'))  // false

    // ================= 2. 边界符 ^ 和 $ =================
    // 1) ^ 匹配开头的位置
    const reg1 = /^web/
    console.log(reg1.test('web前端'))   // true
    console.log(reg1.test('前端web'))   // false
    console.log(reg1.test('前端web学习')) // false
    console.log(reg1.test('we'))        // false

    // 2) $ 匹配结束的位置
    const reg2 = /web$/
    console.log(reg2.test('web前端'))   // false
    console.log(reg2.test('前端web'))   // true
    console.log(reg2.test('前端web学习')) // false
    console.log(reg2.test('we'))        // false

    // 3) ^ 和 $ 在一起 => 精确匹配
    const reg3 = /^web$/
    console.log(reg3.test('web前端'))   // false
    console.log(reg3.test('前端web'))   // false
    console.log(reg3.test('web'))       // true
    console.log(reg3.test('webweb'))    // false

    // ================= 3. 量词 =================
    // * 重复次数 >= 0
    const reg4 = /^w*$/
    console.log(reg4.test(''))   // true
    console.log(reg4.test('w'))  // true
    console.log(reg4.test('ww')) // true

    // + 重复次数 >= 1
    const reg5 = /^w+$/
    console.log(reg5.test(''))   // false
    console.log(reg5.test('w'))  // true
    console.log(reg5.test('ww')) // true

    // ? 重复次数 0 或 1
    const reg6 = /^w?$/
    console.log(reg6.test(''))   // true
    console.log(reg6.test('w'))  // true
    console.log(reg6.test('ww')) // false

    // {n} 重复 n 次
    const reg7 = /^w{3}$/
    console.log(reg7.test('ww'))   // false
    console.log(reg7.test('www'))  // true
    console.log(reg7.test('wwww')) // false

    // {n,} 重复次数 >= n
    const reg8 = /^w{2,}$/
    console.log(reg8.test('w'))   // false
    console.log(reg8.test('ww'))  // true

    // {n,m} n <= 重复次数 <= m
    const reg9 = /^w{2,4}$/
    console.log(reg9.test('w'))     // false
    console.log(reg9.test('ww'))    // true
    console.log(reg9.test('wwwww')) // false

    // ================= 4. 范围 [] =================
    // [abc] 多选 1
    const regA = /^[abc]$/
    console.log(regA.test('a'))  // true
    console.log(regA.test('d'))  // false
    console.log(regA.test('ab')) // false

    // [a-z] 连字符,单个字符
    const regB = /^[a-z]$/
    console.log(regB.test('a'))  // true
    console.log(regB.test('A'))  // false

    // 小写 + 大写 + 数字
    const regC = /^[a-zA-Z0-9]$/
    console.log(regC.test('B')) // true
    console.log(regC.test(9))   // true
    console.log(regC.test(',')) // false

    // 用户名:字母、数字、下划线,6~16 位
    const regD = /^[a-zA-Z0-9_]{6,16}$/
    console.log(regD.test('abcd1'))   // false
    console.log(regD.test('abcd12'))  // true
    console.log(regD.test('ABcd12_')) // true

    // [^a-z] 取反
    const regE = /^[^a-z]$/
    console.log(regE.test('a')) // false
    console.log(regE.test('A')) // true
    console.log(regE.test(8))   // true
  </script>
</body>关键行与易错点
/web/是正则字面量,/ /之间才是规则;reg.test(str)返回布尔值,匹配上为true。^只约束开头、$只约束结尾,两个一起用才是精确匹配,这也是/^web$/测'webweb'为false的原因。- 量词
{n,m}里的逗号两侧千万不能有空格,写成/^w{2, 4}$/会匹配失败。 []只能匹配一个字符,/^[abc]$/测'ab'是false;[^a-z]的^写在方括号里表示取反,和边界符^含义完全不同。test()的参数会被当成字符串处理,所以regC.test(9)相当于测'9'。
示例 2:replace 替换与修饰符 g / i
html
<body>
  <script>
    const str = '欢迎大家学习前端,相信大家一定能学好前端,都成为前端大神'

    // 1. 不加修饰符:只能替换第一个匹配到的
    const strEnd1 = str.replace(/前端/, 'web')
    console.log(strEnd1)
    // 欢迎大家学习web,相信大家一定能学好前端,都成为前端大神

    // 2. 修饰符 g(global):全部替换
    const strEnd2 = str.replace(/前端/g, 'web')
    console.log(strEnd2)
    // 欢迎大家学习web,相信大家一定能学好web,都成为web大神

    // 3. 修饰符 i(ignore):不区分大小写
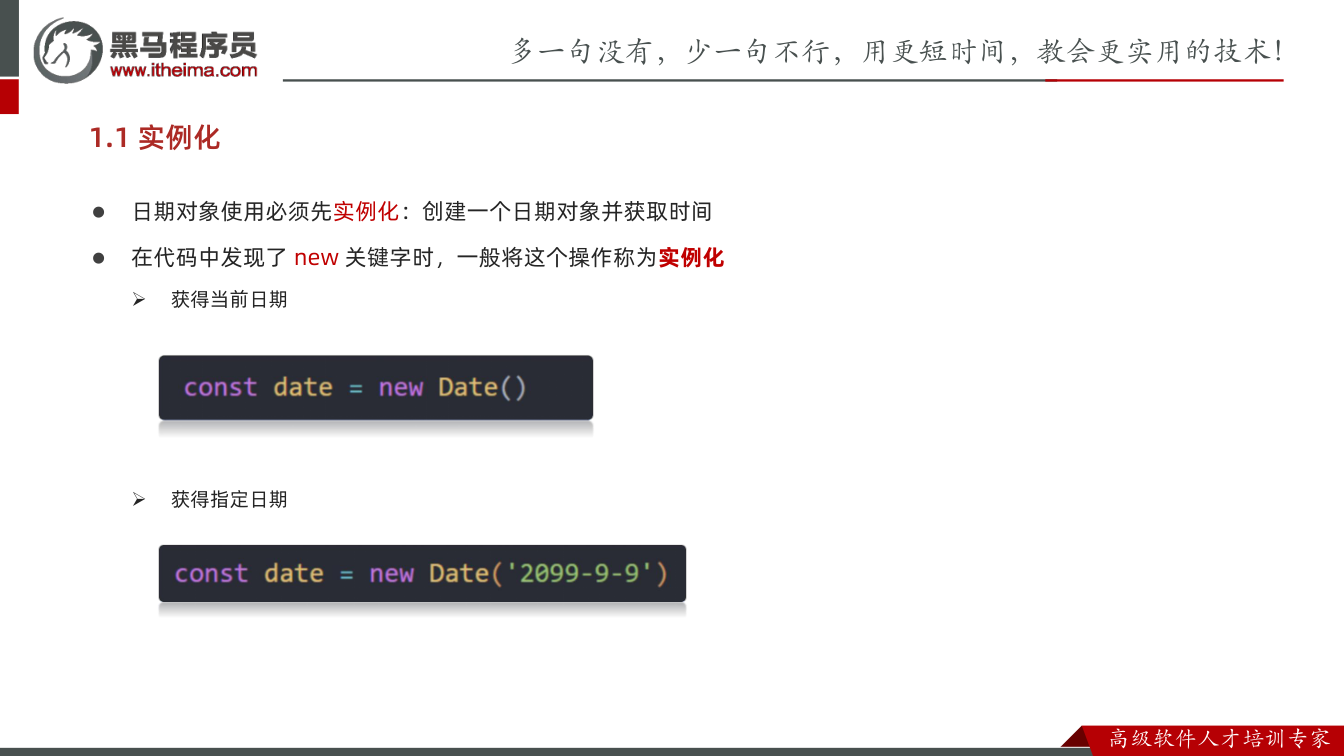
    const str2 = 'WEB前端开发,Web真好玩'
    console.log(str2.replace(/web/gi, 'H5'))
    // H5前端开发,H5真好玩

    // 4. 返回值是替换完毕的新字符串,原字符串不变
    console.log(str === strEnd2) // false
  </script>
</body>关键行与易错点
replace(正则, 新内容)返回的是替换完成后的新字符串,必须接收返回值;不接收就“看起来没生效”。- 不加
g时只替换第一处,这是很多同学“只替换了一个”的根因。 g表示全局匹配,i表示忽略大小写,可以合写成/web/gi。- 过滤敏感词、批量改文案都用这套写法:
str.replace(/敏感词/g, '***')。
示例 3:学生就业统计表 —— 本地存储渲染 + 新增业务
html
<!DOCTYPE html>
<html lang="zh-CN">
<head>
  <meta charset="UTF-8">
  <title>学生就业统计表</title>
  <style>
    table { border-collapse: collapse; width: 900px; margin: 20px auto; text-align: center; }
    th, td { border: 1px solid #ccc; padding: 8px; }
    th { background: #f5f5f5; }
    .info { width: 900px; margin: 0 auto; }
    .title { width: 900px; margin: 10px auto; }
  </style>
</head>
<body>
  <h1 style="text-align:center">学生就业统计表</h1>

  <!-- 表单模块 -->
  <form class="info">
    姓名:<input type="text" class="uname">
    年龄:<input type="text" class="age">
    薪资:<input type="text" class="salary">
    性别:<select class="gender">
      <option value="男">男</option>
      <option value="女">女</option>
    </select>
    城市:<select class="city">
      <option value="北京">北京</option>
      <option value="上海">上海</option>
      <option value="曹县">曹县</option>
    </select>
    <button type="submit">添加</button>
  </form>

  <!-- 数据条数模块 -->
  <div class="title">共有 <span>0</span> 条数据</div>

  <!-- 表格模块 -->
  <table>
    <thead>
      <tr>
        <th>ID</th><th>姓名</th><th>年龄</th><th>性别</th>
        <th>薪资</th><th>就业城市</th><th>录入时间</th><th>操作</th>
      </tr>
    </thead>
    <tbody></tbody>
  </table>

  <script>
    // ============ 0. 初始数据(只存一次,存完必须注释掉) ============
    const initData = [{
      stuId: 1,
      uname: '迪丽热巴',
      age: 23,
      gender: '女',
      salary: 13000,
      city: '北京',
      time: new Date().toLocaleString()
    }]
    // localStorage.setItem('data', JSON.stringify(initData))

    // ============ 1. 读取本地存储数据 ============
    // 有数据:JSON.parse 转成对象数组;没数据:用空数组代替(逻辑或中断)
    const arr = JSON.parse(localStorage.getItem('data')) || []
    console.log(arr)

    // ============ 2. 渲染业务 ============
    const tbody = document.querySelector('tbody')

    function render() {
      // 第一步:map 遍历数组,返回一个装满 tr 字符串的新数组
      const trArr = arr.map(function (ele) {
        return `<tr>
          <td>${ele.stuId}</td>
          <td>${ele.uname}</td>
          <td>${ele.age}</td>
          <td>${ele.gender}</td>
          <td>${ele.salary}</td>
          <td>${ele.city}</td>
          <td>${ele.time}</td>
          <td><a href="javascript:;">删除</a></td>
        </tr>`
      })

      // 第二步:join('') 把数组转成字符串,第三步:追加给 tbody
      tbody.innerHTML = trArr.join('')

      // 数据条数 = 数组的长度
      document.querySelector('.title span').innerHTML = arr.length
    }
    render()

    // ============ 3. 新增业务 ============
    const info = document.querySelector('.info')
    const uname = document.querySelector('.uname')
    const age = document.querySelector('.age')
    const salary = document.querySelector('.salary')
    const gender = document.querySelector('.gender')
    const city = document.querySelector('.city')

    info.addEventListener('submit', function (e) {
      // 阻止表单默认提交(跳转/刷新)
      e.preventDefault()

      // 非空判断:姓名、年龄、薪资不能为空(性别、城市有默认值,不用判断)
      if (!uname.value || !age.value || !salary.value) {
        return alert('输入内容不能为空')
      }

      // 数据发生变化:先改数据,再存本地,最后重新渲染
      arr.push({
        stuId: arr.length + 1,
        uname: uname.value,
        age: age.value,
        gender: gender.value,
        salary: salary.value,
        city: city.value,
        time: new Date().toLocaleString()
      })

      localStorage.setItem('data', JSON.stringify(arr))
      render()

      // 清空表单,方便继续录入
      info.reset()
    })
  </script>
</body>关键行与易错点
localStorage只能存字符串,存之前必须JSON.stringify(initData),取出来必须JSON.parse(...),否则拿到的是一串 JSON 文本而不是对象数组。JSON.parse(localStorage.getItem('data')) || []用的是逻辑或中断:本地有数据就用解析结果,本地被清空时getItem返回null,此时自动兜底成空数组,避免后面map报错。map里必须return,否则新数组里全是undefined;map与forEach的最大区别就是map有返回值(新数组)。trArr是数组,不能直接tbody.innerHTML = trArr,必须join('')转成字符串再赋值,否则页面会显示成逗号分隔的乱码。- 条数提示用
arr.length,不是写死的数字,这样增删后自动同步。 localStorage.setItem('data', JSON.stringify(initData))这一行测试完一定要注释掉,否则每次刷新页面都会把旧数据覆盖回去,后面的新增就“白做了”。- 提交事件里别忘
e.preventDefault();非空判断用return alert(...),return会直接结束函数,后面新增逻辑不再执行。 - 新增的正确顺序是:改数据 → 存本地 → 重新渲染,删改同理,这样页面刷新后数据依然不丢失。
常见错误
1. 校验手机号/用户名时漏写 ^ 和 $
- 现象:
/1[3-9]\d{9}/.test('abc13800138000xyz')返回true,非法输入被放行。 - 原因:没加边界符时
test只要求“串里存在一段能匹配的子串”,不要求整串匹配。 - 修法:做表单校验一律写成
/^...$/,把“包含”变成“完全等于”。
2. 量词里混入空格或中文逗号
- 现象:
/^[a-z]{6, 16}$/对abcdef返回false,怎么调都不对。 - 原因:
{6, 16}中的空格、全角,都是正则里的普通字符,量词解析失败,规则整体语义变了。 - 修法:量词内只允许半角、无空格:
{6,16};写完用几个边界值(5/6/16/17 位)各测一遍。
3. 替换只生效一次
- 现象:
str.replace(/前端/, 'web')只换了第一个“前端”,后面的原样保留。 - 原因:默认非全局匹配,
replace遇到第一个命中就停。 - 修法:加
g:str.replace(/前端/g, 'web');若还需忽略大小写则/前端/gi。替换结果要用返回值接收,replace不改原串。
4. 带 g 的正则反复调用 test() 结果忽真忽假
- 现象:同一个
/a/g连续test('abc'),第一次true,第二次false。 - 原因:
g会让正则对象记住上次匹配结束的lastIndex,下次从那里继续找,状态被污染。 - 修法:纯校验用不带
g的正则;确需复用则每次重置reg.lastIndex = 0,或干脆每次新建正则。
5. 误把 [^...] 当成“整串取反”,或把 ^ 位置搞混
- 现象:
/^[^a-z]$/想校验“不是纯小写字母的串”,结果'ABC'返回false。 - 原因:
[]内的^只对单个字符取反,且外面还有^...$限定长度必须为 1。 - 修法:明确区分“字符集取反”和“位置锚定”;要多字符场景用
+/*配合,如/^[^a-z]+$/。
6. 渲染时把 map 的返回值直接赋给 innerHTML
- 现象:页面出现
[object HTMLTableRowElement],[object ...]或标签之间多个逗号。 - 原因:
map返回的是数组,赋给innerHTML时会隐式调用toString(),用逗号拼接。 - 修法:必须
.join('')转成字符串再赋值;同时localStorage存数组前JSON.stringify,取时JSON.parse并用|| []兜底。
练习
写一个正则,校验 11 位手机号:以
1开头、第二位3-9、后面 9 位数字。再用'13800138000'、'12800138000'、'138001380001'、'1380013800a'四个值验证。写一个用户名规则:只能由英文字母、数字、下划线组成,长度 6~16 位。请分别用
{n,m}量词和+配合边界符两种写法实现,并说明哪种更易读。给定字符串
'前端开发很快乐,前端工程师很吃香,前端前景好',把所有“前端”替换成“Web 前端”,再写一版忽略大小写地把'HTML'与'html'全部替换成'HTML5'。用
map+join('')把[{id:1,name:'迪丽热巴',age:23},{id:2,name:'古力娜扎',age:22}]渲染成两行<tr>字符串,并把结果追加到tbody中。写一个
render():先从localStorage取date并JSON.parse,无数据时用空数组兜底;然后渲染表格并同步更新标题里“共 N 条数据”的span。思考:如果存进去的数据被手动改坏成非 JSON,代码会怎样?如何加一层容错?
原视频对照
| # | 视频 | 时长 |
|---|---|---|
| 1 | 综合案例-布局和业务分析 | 07:03 |
| 2 | 综合案例-读取本地存储数据 | 08:08 |
| 3 | 数组map和join方法 | 12:17 |
| 4 | 综合案例-渲染模块利用map遍历数组生成tr | 10:53 |
| 5 | 综合案例-渲染模块完成 | 04:41 |
| 6 | 综合案例-新增业务提交和非空判断 | 05:34 |
小结
- 正则校验的第一原则是“整串匹配”,业务校验场景几乎都要
^ ... $,漏掉边界符是最常见也最隐蔽的漏洞。 - 元字符的价值在于“用规则描述集合”,
[a-z]之于 26 个字母、\d之于 0-9,写法越短越要保持可读性,量词与字符集分工要清楚。 - 量词表达“次数”,范围表达“字符种类”,两者组合才是完整规则;任何多余空格、全角符号都会让规则悄悄失效。
replace默认单次、区分大小写,g与i是行为开关;带g的正则对象有状态,不适合反复test复用。map是“加工数据并返回新数组”,join是“数组转字符串”,渲染 =map造结构 +join('')拼串 +innerHTML落盘,三步缺一不可。- 本地存储只能存字符串,读写必须成对使用
JSON.stringify/JSON.parse,并对“无数据”和“脏数据”都做兜底。 - 数据驱动思维:先改数据、再存本地、最后重渲染;渲染逻辑封装成函数,新增与删除都复用它,页面才不会出现数据与视图不一致。