主题
2-17综合案例-学生统计表案例(二)
本页对应 第二章WebAPIs,共 6 段视频,约 44 分钟。
学习目标
- 能够根据表单输入生成包含
stuId、uname、age、salary、gender、city、time等字段的学生对象,追加到数组后调用渲染函数更新页面,并使用表单重置方法清空输入。 - 能够使用
localStorage.setItem与JSON.stringify保存最新数组数据,使用localStorage.getItem与JSON.parse读取数据,并通过刷新页面验证新增、删除后的数据不丢失。 - 能够使用事件委托为
tbody注册点击事件,通过判断目标元素和自定义属性获取当前删除项索引,使用splice删除对应数据并重新渲染页面。 - 能够在删除操作中加入
confirm确认框,并根据返回值决定是否执行删除,同时将删除后的最新数组同步保存到本地存储。 - 能够按“数组最后一条数据的
stuId + 1”生成新学号,并使用三元表达式处理空数组时默认stuId为 1 的情况,避免学号重复和空数组报错。 - 能够使用正则表达式的替换方法和修饰符完成字符串替换、全局匹配或不区分大小写匹配,并验证替换结果符合预期。
知识点
正则表达式是什么
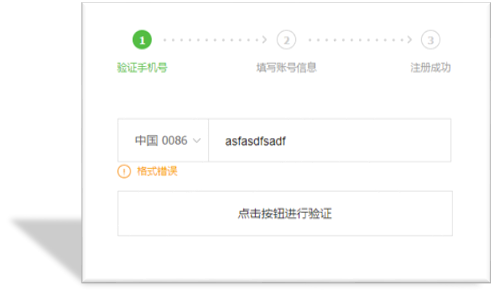
正则表达式(Regular Expression)是一种字符串匹配的模式(规则)。它把“什么样的字符串算合法/算目标”写成规则,再用规则去测试、替换或提取。典型场景是表单验证:比如手机号要求只能输入 11 位数字;也用于过滤敏感词、从字符串中提取特定部分。
正则基本使用
为什么需要:如果不用规则,就只能写大量字符判断,代码长且难维护。怎么想:先把需求翻译成“规则对象”,再用 test() 看目标字符串是否匹配。怎么做:/表达式/ 是正则字面量,正则也是对象;test() 返回布尔值。易错点:test() 判断的是“是否匹配”,不是返回匹配内容;初学先区分“包含匹配”和后面的“精确匹配”。
html
<body>
  <script>
    // 正则表达式的基本使用
    const str = 'web前端开发'
    // 1. 定义规则
    const reg = /web/

    // 2. 使用正则  test()
    console.log(reg.test(str))  // true  如果符合规则匹配上则返回true
    console.log(reg.test('java开发'))  // false  如果不符合规则匹配上则返回 false
  </script>
</body>元字符与普通字符
为什么需要:普通字符只能描述它们本身,例如 /[abcdefghijklmnopqrstuvwxyz]/ 很笨重;元字符有特殊含义,能提高灵活性和匹配能力。怎么想:能用范围/简写就不要枚举。怎么做:普通字符匹配相同字符;元字符写法如 /[a-z]/ 表示英文字母范围。易错点:普通字符不是“声明范围”,[abc] 才是多选一;元字符有特殊含义,不能按普通字母理解。
边界符
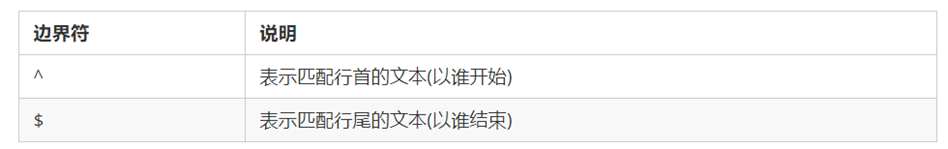
为什么需要:/web/ 只表示“包含 web”,web前端、前端web 都可能命中;很多验证要求“开头/结尾/整体精确”。怎么想:^ 提示开头位置,$ 提示结束位置;^ 和 $ 在一起表示精确匹配。怎么做:看下面代码逐条 test() 验证。易错点:/^web$/ 只匹配 web,不匹配 webweb;边界符管位置,不是匹配字符本身。
html
<body>
  <script>
    // 元字符之边界符
    // 1. 匹配开头的位置 ^
    const reg = /^web/
    console.log(reg.test('web前端'))  // true
    console.log(reg.test('前端web'))  // false
    console.log(reg.test('前端web学习'))  // false
    console.log(reg.test('we'))  // false

    // 2. 匹配结束的位置 $
    const reg1 = /web$/
    console.log(reg1.test('web前端'))  //  false
    console.log(reg1.test('前端web'))  // true
    console.log(reg1.test('前端web学习'))  // false
    console.log(reg1.test('we'))  // false

    // 3. 精确匹配 ^ $
    const reg2 = /^web$/
    console.log(reg2.test('web前端'))  //  false
    console.log(reg2.test('前端web'))  // false
    console.log(reg2.test('前端web学习'))  // false
    console.log(reg2.test('we'))  // false
    console.log(reg2.test('web'))  // true
    console.log(reg2.test('webweb'))  // flase
  </script>
</body>量词
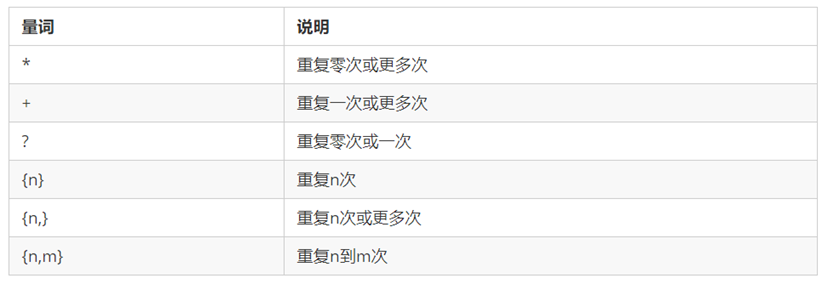
为什么需要:验证经常要求“重复几次”,例如 3 位、至少 2 位、2 到 4 位。怎么想:把量词理解为“前一个模式重复次数”。怎么做:* 表示 ≥0 次,+ 表示 ≥1 次,? 表示 0 或 1 次,{n} 固定 n 次,{n,} ≥n 次,{n,m} 在 n 到 m 次之间。易错点:逗号左右千万不要出现空格,否则匹配失败;* 允许空串,+ 不允许。
html
<body>
  <script>
    // 元字符之量词
    // 1. * 重复次数 >= 0 次
    const reg1 = /^w*$/
    console.log(reg1.test(''))  // true
    console.log(reg1.test('w'))  // true
    console.log(reg1.test('ww'))  // true
    console.log('-----------------------')

    // 2. + 重复次数 >= 1 次
    const reg2 = /^w+$/
    console.log(reg2.test(''))  // false
    console.log(reg2.test('w'))  // true
    console.log(reg2.test('ww'))  // true
    console.log('-----------------------')

    // 3. ? 重复次数  0 || 1
    const reg3 = /^w?$/
    console.log(reg3.test(''))  // true
    console.log(reg3.test('w'))  // true
    console.log(reg3.test('ww'))  // false
    console.log('-----------------------')

    // 4. {n} 重复 n 次
    const reg4 = /^w{3}$/
    console.log(reg4.test(''))  // false
    console.log(reg4.test('w'))  // flase
    console.log(reg4.test('ww'))  // false
    console.log(reg4.test('www'))  // true
    console.log(reg4.test('wwww'))  // false
    console.log('-----------------------')

    // 5. {n,} 重复次数 >= n
    const reg5 = /^w{2,}$/
    console.log(reg5.test(''))  // false
    console.log(reg5.test('w'))  // false
    console.log(reg5.test('ww'))  // true
    console.log(reg5.test('www'))  // true
    console.log('-----------------------')

    // 6. {n,m}   n =< 重复次数 <= m
    const reg6 = /^w{2,4}$/
    console.log(reg6.test('w'))  // false
    console.log(reg6.test('ww'))  // true
    console.log(reg6.test('www'))  // true
    console.log(reg6.test('wwww'))  // true
    console.log(reg6.test('wwwww'))  // false

    // 7. 注意事项: 逗号两侧千万不要加空格否则会匹配失败

  </script>
</body>范围与字符类
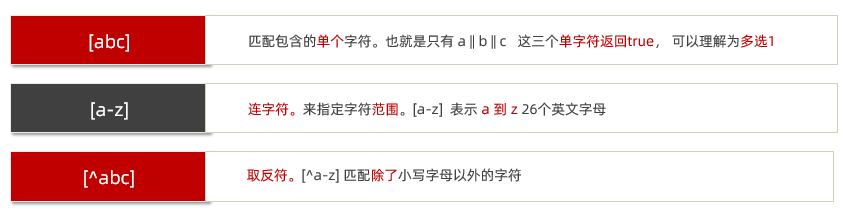
为什么需要:表单常限定“只能是字母/数字/下划线”或“不能是某类字符”。怎么想:[] 表示字符范围,[abc] 多选一,[a-z] 连字符表示范围,[^a-z] 表示取反;字符类是一些常见模式的简写。怎么做:先写范围,再配合量词和边界符做整体验证。易错点:[^a-z] 的 ^ 在方括号内是取反,不是开头;用户名 6~16 位案例中 {6,16} 必须配合 ^...$ 才是整体长度校验。
html
<body>
  <script>
    // 元字符之范围  []
    // 1. [abc] 匹配包含的单个字符, 多选1
    const reg1 = /^[abc]$/
    console.log(reg1.test('a'))  // true
    console.log(reg1.test('b'))  // true
    console.log(reg1.test('c'))  // true
    console.log(reg1.test('d'))  // false
    console.log(reg1.test('ab'))  // false

    // 2. [a-z] 连字符 单个
    const reg2 = /^[a-z]$/
    console.log(reg2.test('a'))  // true
    console.log(reg2.test('p'))  // true
    console.log(reg2.test('0'))  // false
    console.log(reg2.test('A'))  // false
    // 想要包含小写字母,大写字母 ,数字
    const reg3 = /^[a-zA-Z0-9]$/
    console.log(reg3.test('B'))  // true
    console.log(reg3.test('b'))  // true
    console.log(reg3.test(9))  // true
    console.log(reg3.test(','))  // flase

    // 用户名可以输入英文字母,数字,可以加下划线,要求 6~16位
    const reg4 = /^[a-zA-Z0-9_]{6,16}$/
    console.log(reg4.test('abcd1'))  // false
    console.log(reg4.test('abcd12'))  // true
    console.log(reg4.test('ABcd12'))  // true
    console.log(reg4.test('ABcd12_'))  // true

    // 3. [^a-z] 取反符
    const reg5 = /^[^a-z]$/
    console.log(reg5.test('a'))  // false
    console.log(reg5.test('A'))  // true
    console.log(reg5.test(8))  // true

  </script>
</body>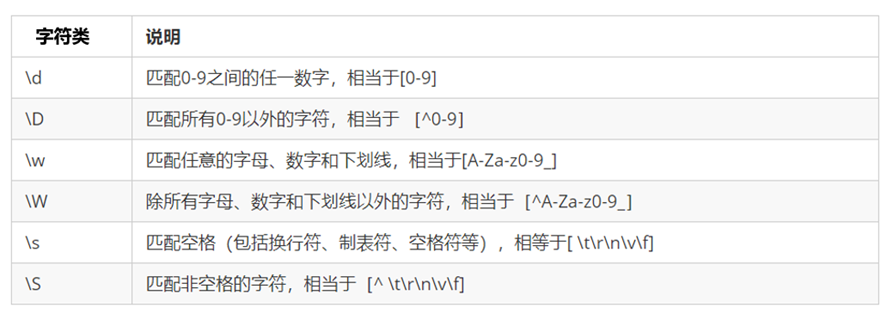
调试与场景补充
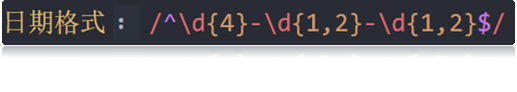
转写稿中的综合案例反复用表单验证:用户名要求 6 到 10 位、手机号 11 位、密码 6 到 20 位、确认密码要与上面一致;输入不合法时提示“不合法”。这里要把“非空判断”写对(转写稿里的“飞空判断”是同音误写),把“索引号”写对(“缩引号”),把数组 array、JSON 字符串等术语纠正。调试正则时,最稳的方式就是像笔记代码一样,用 console.log(reg.test(...)) 先测合法值,再测边界值:空串、少一位、多一位、大小写、数字和符号。只有先确认规则本身正确,再放进表单事件里提示用户,才不会把“规则错”误判成“事件没绑定”。
本节要解决的问题
这一节学习两个紧密相关的知识点:replace 替换方法和正则修饰符。笔记中的需求很明确:把字符串“欢迎大家学习前端,相信大家一定能学好前端,都成为前端大神”里的“前端”替换成“web”。如果直接写 replace,只能替换第一个“前端”;如果加上修饰符 g,才能把所有“前端”都替换掉。
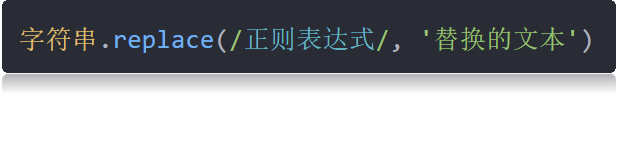
先看笔记中的示意图:
转写稿主体讲的是后续综合案例中的新增、删除、本地存储等内容,并没有展开 replace 的具体调试过程,因此这里不把综合案例逻辑硬套到本节。转写稿中反复出现“正则表达式”,可以确认本节处在正则表达式学习阶段;其中“耳瑞/aree”应理解为 array,“杰森”应理解为 JSON,这些属于后续案例,本节先聚焦 replace 和修饰符。
replace 的基本用法
为什么需要:字符串中的内容经常需要批量或局部替换,例如把“前端”改成“web”,把敏感词替换成 ***。手动查找再拼接很麻烦,replace 可以直接返回替换后的新字符串。
怎么想:replace 的基本形式是 字符串.replace(要匹配的内容, 替换成的内容)。要匹配的内容可以是普通字符串,也可以是正则表达式;第二个参数是替换后的内容。
怎么做:先写最基础的版本:
html
<body>
  <script>
    // 替换和修饰符
    const str = '欢迎大家学习前端,相信大家一定能学好前端,都成为前端大神'
    // 1. 替换  replace  需求:把前端替换为 web
    // 1.1 replace 返回值是替换完毕的字符串
    // const strEnd = str.replace(/前端/, 'web') 只能替换一个
  </script>
</body>这里要特别注意:replace 的返回值才是替换完毕的字符串。也就是说,不能只写 str.replace(/前端/, 'web') 就以为原字符串变了;如果想使用结果,应当接收返回值,例如 const strEnd = str.replace(/前端/, 'web')。
易错点:replace 不会修改原字符串。字符串本身是不可变的,替换结果通过返回值给出。另一个易错点是正则字面量不要写成字符串,例如不要写成 replace('/前端/', 'web'),那会按普通字符串去匹配,而不是按正则表达式匹配。
为什么只替换一个
为什么需要:笔记中明确写了“只能替换一个”。这不是 replace 写错了,而是因为正则 /前端/ 没有加全局修饰符,默认只匹配第一个满足条件的位置。
怎么想:先观察原字符串,里面出现了两次“前端”。如果只用 /前端/,执行结果只会把第一处替换掉,第二处仍然是“前端”。
怎么做:可以先用注释中的写法验证:
js
const strEnd = str.replace(/前端/, 'web')
console.log(strEnd)运行后应当看到第一个“前端”变成“web”,第二个“前端”保持不变。这个现象是理解 g 修饰符的入口。
易错点:不要误以为 replace 天生就会替换全部。默认行为是匹配一次、替换一次;要全部替换,必须让正则具备全局匹配能力。
修饰符 g:全局替换
为什么需要:需求是“把前端替换为 web”,从语义上看,两处“前端”都应当被替换。只替换第一个显然不完整。
怎么想:g 是单词 global 的缩写,表示全局匹配。把 g 写在正则字面量的斜杠后面,例如 /前端/g,就能匹配所有满足正则表达式的结果。
怎么做:笔记中的完整写法是:
html
<body>
  <script>
    // 替换和修饰符
    const str = '欢迎大家学习前端,相信大家一定能学好前端,都成为前端大神'
    // 1. 替换  replace  需求:把前端替换为 web
    // 1.1 replace 返回值是替换完毕的字符串
    // const strEnd = str.replace(/前端/, 'web') 只能替换一个

    // 2. 修饰符 g 全部替换
    const strEnd = str.replace(/前端/g, 'web')
    console.log(strEnd)
  </script>
</body>此时 strEnd 中所有“前端”都会变成“web”。原字符串 str 仍然保持原样。
易错点:g 要写在正则字面量第二个斜杠的后面,不能写在替换内容里;也不要写成 replace('前端/g', 'web'),因为那是普通字符串,不是正则。
修饰符 i:忽略大小写
为什么需要:笔记中说明 i 是单词 ignore 的缩写,正则匹配时字母不区分大小写。做英文内容替换、表单验证时,用户可能输入 Web、WEB、web,如果不忽略大小写,很容易漏匹配。
怎么想:i 控制的是“匹配时是否区分大小写”,g 控制的是“是否全局匹配”。两者解决的是不同问题:i 管大小写,g 管次数。
怎么做:如果要把字符串中的 web 不区分大小写地替换掉,可以写成 /web/i;如果既要忽略大小写又要全部替换,就组合成 /web/gi。修饰符顺序通常不影响含义,gi 和 ig 都可以。
易错点:本节笔记只给出了 i 和 g 的说明,不要额外编造其他修饰符的行为。写组合修饰符时,要写在正则字面量结尾,例如 /前端/gi,而不是 replace(/前端/, 'web', 'g')。
调试与验证思路
为什么需要:替换结果是否符合预期,不能只看代码“像不像”,要打印结果验证。
怎么想:先验证“只替换一个”,再验证“全局替换”,最后再考虑大小写。这样能清楚看到修饰符带来的差异。
怎么做:可以保留两行对比:
js
const one = str.replace(/前端/, 'web')
const all = str.replace(/前端/g, 'web')
console.log(one)
console.log(all)观察 one 和 all 的差异,就能理解 g 的作用。i 可以用英文示例单独验证,例如比较 /web/ 和 /web/i 对 Web 的匹配差异。
易错点:调试时不要把 console.log(str) 和 console.log(strEnd) 混淆;str 是原字符串,strEnd 才是替换后的返回值。
小结
replace 负责替换,返回替换完毕的新字符串;默认只替换第一个匹配项。g 让正则全局匹配,从而替换所有结果;i 让正则匹配时忽略字母大小写。写代码时要牢记:replace 不改变原字符串,修饰符要写在正则字面量后面,全局替换用 /前端/g,需要忽略大小写时再用 i 组合。
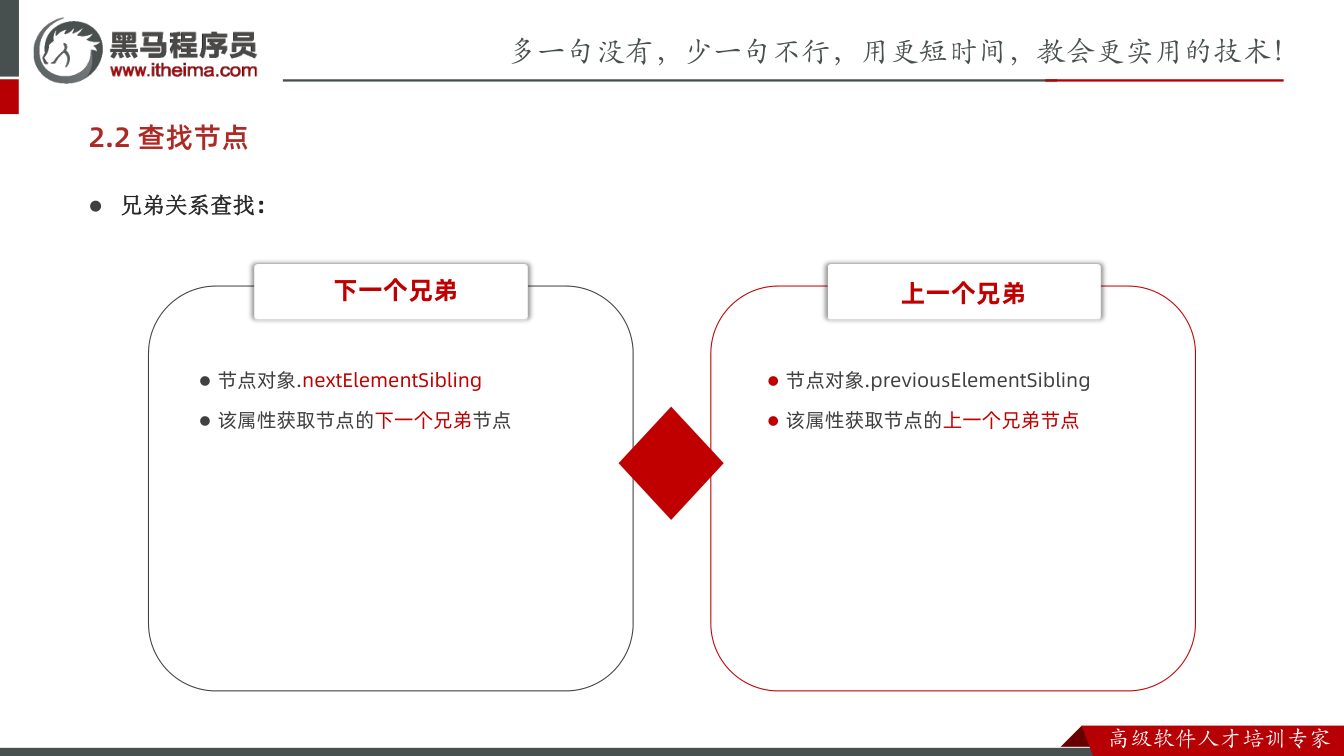
课件图示
代码示例
示例一:正则基本使用 + 边界符
html
<!DOCTYPE html>
<html lang="zh-CN">
<head>
  <meta charset="UTF-8">
  <title>正则基本使用与边界符</title>
</head>
<body>
  <script>
    // 正则表达式的基本使用
    const str = 'web前端开发'
    // 1. 定义规则
    const reg = /web/

    // 2. 使用正则  test()
    console.log(reg.test(str))         // true  如果符合规则匹配上则返回true
    console.log(reg.test('java开发'))  // false 如果不符合规则匹配上则返回 false

    // 元字符之边界符
    // 1. 匹配开头的位置 ^
    const regStart = /^web/
    console.log(regStart.test('web前端'))     // true
    console.log(regStart.test('前端web'))     // false
    console.log(regStart.test('前端web学习')) // false
    console.log(regStart.test('we'))          // false

    // 2. 匹配结束的位置 $
    const regEnd = /web$/
    console.log(regEnd.test('web前端'))     // false
    console.log(regEnd.test('前端web'))     // true
    console.log(regEnd.test('前端web学习')) // false
    console.log(regEnd.test('we'))          // false

    // 3. 精确匹配 ^ $
    const regExact = /^web$/
    console.log(regExact.test('web前端'))     // false
    console.log(regExact.test('前端web'))     // false
    console.log(regExact.test('前端web学习')) // false
    console.log(regExact.test('we'))          // false
    console.log(regExact.test('web'))         // true
    console.log(regExact.test('webweb'))      // false
  </script>
</body>
</html>关键行与易错点
const reg = /web/:/ /之间是正则表达式字面量,正则表达式本身也是对象,不是字符串。reg.test(str):test()用来查看正则与指定字符串是否匹配,返回true/false。^只表示开头位置,$只表示结尾位置;/^web/匹配'web前端',但匹配不了'前端web'。^和$同时出现表示精确匹配:/^web$/只有'web'为true,'webweb'为false。- 易错点:笔记中各片段是分开的独立示例,合并到一个
<script>时不能再重复const reg,否则Identifier 'reg' has already been declared报错,所以这里改名为regStart、regEnd、regExact。
示例二:元字符——量词与范围
html
<!DOCTYPE html>
<html lang="zh-CN">
<head>
  <meta charset="UTF-8">
  <title>元字符:量词与范围</title>
</head>
<body>
  <script>
    // ===== 元字符之量词 =====
    // 1. * 重复次数 >= 0 次
    const regStar = /^w*$/
    console.log(regStar.test(''))   // true
    console.log(regStar.test('w'))  // true
    console.log(regStar.test('ww')) // true

    // 2. + 重复次数 >= 1 次
    const regPlus = /^w+$/
    console.log(regPlus.test(''))   // false
    console.log(regPlus.test('w'))  // true
    console.log(regPlus.test('ww')) // true

    // 3. ? 重复次数 0 || 1
    const regQ = /^w?$/
    console.log(regQ.test(''))   // true
    console.log(regQ.test('w'))  // true
    console.log(regQ.test('ww')) // false

    // 4. {n} 重复 n 次
    const reg3 = /^w{3}$/
    console.log(reg3.test(''))    // false
    console.log(reg3.test('w'))   // false
    console.log(reg3.test('ww'))  // false
    console.log(reg3.test('www')) // true
    console.log(reg3.test('wwww'))// false

    // 5. {n,} 重复次数 >= n
    const reg5 = /^w{2,}$/
    console.log(reg5.test(''))   // false
    console.log(reg5.test('w'))  // false
    console.log(reg5.test('ww')) // true
    console.log(reg5.test('www'))// true

    // 6. {n,m}   n =< 重复次数 <= m
    const reg6 = /^w{2,4}$/
    console.log(reg6.test('w'))     // false
    console.log(reg6.test('ww'))    // true
    console.log(reg6.test('www'))   // true
    console.log(reg6.test('wwww'))  // true
    console.log(reg6.test('wwwww')) // false

    // 7. 注意事项:逗号两侧千万不要加空格否则会匹配失败

    // ===== 元字符之范围 [] =====
    // 1. [abc] 匹配包含的单个字符,多选1
    const regOne = /^[abc]$/
    console.log(regOne.test('a'))  // true
    console.log(regOne.test('b'))  // true
    console.log(regOne.test('c'))  // true
    console.log(regOne.test('d'))  // false
    console.log(regOne.test('ab')) // false

    // 2. [a-z] 连字符 单个
    const regRange = /^[a-z]$/
    console.log(regRange.test('a')) // true
    console.log(regRange.test('p')) // true
    console.log(regRange.test('0')) // false
    console.log(regRange.test('A')) // false

    // 想要包含小写字母,大写字母,数字
    const regMix = /^[a-zA-Z0-9]$/
    console.log(regMix.test('B')) // true
    console.log(regMix.test('b')) // true
    console.log(regMix.test(9))   // true
    console.log(regMix.test(',')) // false

    // 用户名可以输入英文字母,数字,可以加下划线,要求 6~16 位
    const regUser = /^[a-zA-Z0-9_]{6,16}$/
    console.log(regUser.test('abcd1'))   // false
    console.log(regUser.test('abcd12'))  // true
    console.log(regUser.test('ABcd12'))  // true
    console.log(regUser.test('ABcd12_')) // true

    // 3. [^a-z] 取反符
    const regNeg = /^[^a-z]$/
    console.log(regNeg.test('a')) // false
    console.log(regNeg.test('A')) // true
    console.log(regNeg.test(8))   // true
  </script>
</body>
</html>关键行与易错点
- 量词控制某个模式的重复次数:
*是>= 0次,+是>= 1次,?是0 或 1次,{n}恰好 n 次,{n,}至少 n 次,{n,m}是 n 到 m 次。 - 易错点:
{n,m}中逗号两侧千万不要出现空格,否则匹配失败;/^w*$/对空字符串也返回true,/^w+$/对空字符串返回false,两者的区别就在最小值。 []表示范围,只匹配一个字符:/^[abc]$/中'ab'是false;[a-z]只包含小写,'A'和'0'都是false。- 组合写法
/^[a-zA-Z0-9_]{6,16}$/:范围负责"能出现哪些字符",量词负责"出现几位",^ $负责整体精确匹配。 [^a-z]中^放在方括号里面表示取反(不是取反,而是"除了 a-z 以外的字符"),放在外面才是匹配开头。regMix.test(9)返回true:test()参数会被当作字符串处理,数字9变成'9'参与匹配。
示例三:replace 替换与修饰符
html
<!DOCTYPE html>
<html lang="zh-CN">
<head>
  <meta charset="UTF-8">
  <title>替换和修饰符</title>
</head>
<body>
  <script>
    // 替换和修饰符
    const str = '欢迎大家学习前端,相信大家一定能学好前端,都成为前端大神'

    // 1. 替换  replace  需求:把前端替换为 web
    // 1.1 replace 返回值是替换完毕的字符串
    const strOne = str.replace(/前端/, 'web')   // 只能替换一个
    console.log(strOne)

    // 2. 修饰符 g 全部替换
    const strEnd = str.replace(/前端/g, 'web')
    console.log(strEnd)
  </script>
</body>
</html>关键行与易错点
replace()的返回值是替换完毕的新字符串,原字符串str不变;不接收返回值就等于没替换。- 不带修饰符时
str.replace(/前端/, 'web')只替换第一个匹配结果。 g是单词 global 的缩写,匹配所有满足正则表达式的结果,/前端/g才能把两处"前端"全部替换为web。i是单词 ignore 的缩写,正则匹配时字母不区分大小写(笔记中的修饰符说明),可与g一起使用。- 易错点:
replace的第一个参数写成字符串'前端'也能替换,但那样无法配合修饰符做全局/忽略大小写匹配,本节统一用正则字面量写法。
常见错误
现象:
/^web$/.test('web前端')返回false,误以为正则写错。
原因:^和$表示精确匹配,不是“包含”。
修法:只判断包含时去掉^ $;表单整串校验时保留^ $。现象:
/^w{2, 4}$/匹配'ww'失败。
原因:量词{n,m}的逗号两侧写了空格,空格被当成匹配字符。
修法:写成/^w{2,4}$/,量词内部不要加空格。现象:想校验“整串不能是小写字母”,写成
/^[^a-z]$/,结果'AB12'不通过。
原因:[^...]只对单个字符取反,不是对整串取反。
修法:整串校验配合量词,如/^[^a-z]+$/;需要固定长度时用{n,m}。现象:
str.replace(/前端/, 'web')只替换了第一处“前端”。
原因:没有加全局修饰符g。
修法:写成str.replace(/前端/g, 'web');需要忽略大小写再加i。现象:删除一条数据后页面正常,刷新后删除的数据又回来了。
原因:只执行了splice和render,没有把最新数组回写localStorage。
修法:删除后按“改数组 →JSON.stringify持久化 → 重新渲染”执行。现象:新增数据时
stuId重复;全部删除后再新增直接报错。
原因:用arr.length + 1生成编号,或空数组时仍读取最后一条数据的stuId。
修法:用arr.length ? arr[arr.length - 1].stuId + 1 : 1。现象:点击删除按钮拿不到当前行索引,或点到行内其他元素也触发删除。
原因:渲染时没写data-id,或事件委托中没判断点击目标是否为A。
修法:map的index写入data-id;点击后判断e.target.tagName === 'A',再取e.target.dataset.id。现象:点“添加”后表单没有变成预期的空值。
原因:form.reset()是恢复表单默认值,不是强制清空;默认value有值时会被恢复。
修法:需要空值时手动清空对应字段,或确保表单默认值本身为空。
练习
- 写一个精确匹配的正则:用户名只能是英文字母、数字、下划线,长度
6~16位;并说明test('')的结果。 - 判断下列字符串哪些能通过
/^w{2,4}$/:''、'w'、'ww'、'www'、'wwww'、'wwwww'、'ww,ww'。 - 将字符串
'欢迎大家学习前端,前端很重要'中所有“前端”替换为web,写出replace调用。 - 补全删除业务顺序:事件委托绑定
tbody点击 → 判断点击A→ 取data-id→confirm→splice→ 持久化 → 重新渲染。写出关键代码结构。 - 新增数据后要求刷新不丢失:写出“生成对象 → 追加数组 → 持久化 → 渲染 → 重置表单”的关键调用顺序。
原视频对照
| # | 视频 | 时长 |
|---|---|---|
| 1 | 综合案例-新增业务生成数据和渲染页面 | 11:36 |
| 2 | 综合案例-新增业务实现本地存储 | 05:17 |
| 3 | 综合案例-删除业务上 | 07:44 |
| 4 | 综合案例-删除业务下 | 05:53 |
| 5 | 综合案例-关于stuId的处理 | 10:44 |
| 6 | 今日内容 | 03:31 |
小结
- 表单整串校验优先使用
^...$;只做包含/查找时不要乱加边界符。 - 量词和范围写法中,空格会参与匹配,
{2,4}不能写成{2, 4}。 [^...]只对单个字符取反,整串校验必须配合量词。- 动态渲染的删除按钮优先用事件委托,索引通过
data-id传递。 - 新增、删除后都要按“修改数组 → 持久化 → 重渲染”的顺序收尾。
- 本地存储存数组必须
JSON.stringify,读取后再JSON.parse。 stuId生成要基于最后一条数据的stuId + 1,空数组回退为1。form.reset()是恢复默认值,不保证字段一定为空。